Cómo escribir una spec para agentes de IA: plantilla, formato EARS y ejemplos
Cómo escribir una spec con la que un agente de IA pueda construir: plantilla para copiar, requisitos EARS, límites en tres niveles, el paso de entrevista y una prueba real de un prompt de una línea contra la spec.
Una spec solo es buena si alguien sin nada de tu contexto puede leerla y construir lo correcto. Esa prueba es todo el trabajo.
Una spec con la que un agente de IA puede construir es un archivo markdown autocontenido. Nombra los archivos y las interfaces, lista lo que queda fuera del alcance, escribe cada requisito como una frase EARS verificable (WHEN [disparador], THE SYSTEM SHALL [respuesta]) con ejemplos de entrada y salida, fija límites en tres niveles (siempre, pregunta antes, nunca) y termina con un paso de verificación que demuestra que la feature funciona. Pídele al agente que te entreviste para redactarla y después constrúyela en una sesión nueva.
Lo probé el 13 de octubre de 2026. Una feature de pagos, construida dos veces por Claude Code con el mismo modelo: una desde un prompt de una línea, otra desde esta plantilla. La ejecución de una línea pasó 8 de 14 chequeos de aceptación y la ejecución con spec pasó 14 de 14. Las dos crearon exactamente un cobro con 50 reintentos concurrentes. El setup y todos los números están abajo.
Anthropic dice cuál es el objetivo sin rodeos en sus Claude Code best practices: “las specs más útiles son autocontenidas: nombran los archivos y las interfaces involucradas, dicen qué queda fuera del alcance y terminan con un paso de verificación de punta a punta que demuestra que la feature funciona.” Esa es la vara. El resto de este texto es cómo pasarla.
La mayoría de quienes prueban Spec-Driven Development ya entiende el porqué. Leyó qué es Spec-Driven Development, cree que la spec es el artefacto correcto para darle a un agente de IA, y entonces abre un archivo en blanco y escribe: “El sistema debe manejar la autenticación de usuarios de forma segura.” Después no entiende por qué el resultado sigue saliendo mal.
El problema no es la falta de compromiso. Escribir una buena spec es una habilidad en sí misma, y casi nada la enseña. Este artículo cubre una prueba medida, la prueba de calidad de una spec, el formato de frase que cierra la ambigüedad, lo que tienes que excluir de forma explícita, los límites y el paso de entrevista, un ejemplo completo de una fintech real y una plantilla para copiar y pegar.
Es el complemento práctico de Spec-Driven Development con Claude Code y del caso de estudio que muestra lo que estos documentos producen a escala.
Libro gratis · en inglés · 169 páginas
Escribir una spec es una habilidad que casi nadie enseña. El libro está en inglés, pero sus plantillas en EARS son markdown y sirven tal cual en tu proyecto.
Recibir el libro gratisLo probé: prompt de una línea vs spec, mismo agente
Afirmar cosas sobre las specs sale barato. Así que construí la misma feature dos veces y medí las dos ejecuciones.
La feature es la del ejemplo de pagos más abajo: hacer idempotente el POST /v1/charges, para que una petición reintentada nunca le cobre dos veces al cliente. La elegí porque tiene edge cases reales: reintentos concurrentes, un replay con otro monto, una clave que expira y una petición que falla la validación antes de contar.
Setup
| Ítem | Las dos ejecuciones |
|---|---|
| Fecha | 13 de octubre de 2026 |
| Agente | Claude Code 2.1.296, headless: claude -p --output-format json, modo de permisos bypassPermissions (nadie a quien preguntar), sin MCP servers, sin configuración de usuario |
| Modelo | Claude Sonnet 5.5 (claude-sonnet-5-5) en las dos |
| Repo | Una API de cobros mínima: 247 líneas de TypeScript en Node 22, cero dependencias, 4 tests, un almacén asíncrono en memoria con unique constraints. Mismo commit inicial para las dos. |
| Entrada de la ejecución de una línea | "Add idempotency key support to POST /v1/charges so client retries never double-charge a customer." |
| Entrada de la ejecución con spec | La plantilla de este artículo: requirements.md (8 requisitos EARS, Non-Goals, tabla de aceptación, Implementation FAQ, Boundaries, Verification), design.md, tasks.md: 151 líneas de markdown, más un archivo .status. |
| Juez | 14 tests de aceptación que escribí antes de las dos ejecuciones, guardados fuera de los dos repos. El agente nunca los vio. El código sin cambios pasa 4 de 14. |
Misma feature, mismo modelo, dos entradas
- Spec: chequeos aprobados
- 14/14
- Prompt de una línea: 8/14
- Cobro con 50 reintentos concurrentes
- 1
- En las dos ejecuciones
- Costo de la ejecución con spec
- US$ 0,119
- Prompt de una línea: US$ 0,098 (+21%)
- Tokens de la ejecución con spec
- 91,7k
- Prompt de una línea: 83,3k (+10%)
- Tiempo de agente de la ejecución con spec
- 31 s
- Ejecución de una línea: 25 s
No todos los chequeos son justos con un prompt de una línea, así que dividí los 14 en tres grupos antes de correr nada:
Resultado por grupo
| Grupo | Qué chequea | Prompt de una línea | Spec |
|---|---|---|---|
| Seguridad (5) | El replay devuelve el mismo cobro; 50 peticiones concurrentes generan un cobro y todas tienen éxito; claves por merchant; las peticiones sin clave no cambian; ningún campo interno se filtra | 4/5 | 5/5 |
| Criterio (3) | Rechazar una clave reusada con otro monto; una petición fallida no quema la clave; rechazar una clave de 10.000 caracteres | 3/3 | 3/3 |
| Decisiones de la spec (6) | 201 y luego 200 en el replay; el header de replay; el mensaje exacto del 422; 400 para claves inválidas; un replay a las 23h59 devuelve 200; un replay pasadas 24 horas crea un cobro nuevo | 1/6 | 6/6 |
Lo que el prompt de una línea hizo bien
Más de lo que esperaba. Reservó la clave con una unique constraint antes de crear el cobro, así que 50 reintentos concurrentes generaron exactamente un cobro. Rechazó la clave reusada con otro monto, dejó la clave libre después de una petición fallida, limitó el largo de la clave y hasta llamó al header de replay Idempotent-Replayed, el mismo nombre que usaba mi spec. Un modelo actual sabe qué es la idempotencia sin spec.
Lo que adivinó distinto
Cinco decisiones, seis chequeos reprobados. Cada apuesta se defiende sola. Ninguna es la que yo quería:
Dónde adivinó la ejecución de una línea
| Decisión | El prompt de una línea adivinó | La spec decía |
|---|---|---|
| Llega un duplicado mientras el primero sigue en curso | 409 + Retry-After (49 de 50 peticiones) | 200 con el cobro del ganador |
| Vida de la clave | Para siempre | 24 horas desde el createdAt del cobro |
| Status del replay | El 201 original | 200 |
| Clave vacía o de 256 caracteres | 422 | 400 |
| Misma clave, otro monto | 422 "Idempotency-Key was already used with different parameters" | 422 "Idempotency-Key reused with different parameters" |
También reportó su propio agujero, mérito suyo: la clave y el cobro son dos escrituras separadas, así que un crash entre ellas deja la clave atascada “en curso” y cada reintento recibe 409 para siempre. Mi design.md eligió otro mecanismo: la clave vive en la propia fila del cobro y la unique constraint hace el trabajo, así que hay una sola escritura y ningún estado atascado. Esa elección fue mía, no del agente.
El retrabajo de la ejecución de una línea: agregar expiración, cambiar lo que reciben los duplicados concurrentes y corregir tres cosas que ve el cliente. En una API real, eso lo descubres cuando el equipo de mobile ya publicó contra el status code equivocado.
Dónde resbaló la ejecución con spec
En dos puntos. Se saltó la reformulación del “Confirm before building” y fue directo al código (headless, no había nadie para leerla). Y donde la spec no decía nada, cuando los tres intentos de insert pierden una carrera, eligió un 409 por su cuenta y lo avisó en el resumen. Respetó todas las líneas de Never: ninguna dependencia, tests existentes intactos, GET sin cambios. Y cerró citando la salida de los tests (# tests 14, # pass 14, # fail 0) porque la spec pedía evidencia y no “debería pasar”.
Qué muestra esta prueba, y qué no
La spec no volvió más inteligente al agente. Hizo que las decisiones fueran mías. Cinco de los seis chequeos que reprobó la ejecución de una línea llevan a una pregunta que el propio agente planteó cuando corrí el paso de entrevista en el mismo repo inicial (las preguntas están abajo); el sexto es la redacción de un mensaje de error. Sabía qué preguntar y, sin spec, se respondió solo.
Los límites: n=1. Un modelo, un repo de 247 líneas, una feature. Escribí tanto la spec como la lista de chequeos. El agente nunca vio el archivo de tests, pero la tabla de aceptación de la spec describe 12 de los 14 chequeos en palabras, porque poner los criterios de aceptación en la spec es el método; y el design.md le dio el mecanismo. Así que la ejecución con spec se evaluó contra criterios que había leído, y la de una línea contra criterios que no podía conocer. Ese es el objetivo de una spec y también el sesgo de esta prueba. La ejecución con spec costó US$ 0,021 más de agente; mi tiempo escribiendo la spec no lo medí. Guardé los logs JSON crudos, los diffs y los tests de aceptación de las dos ejecuciones.
La única prueba de una buena spec
La prueba va antes que cualquier plantilla.
No le dirías: “Haz eso de las tareas.”
Le dirías: “Cuando alguien crea una tarea, guarda el título, verifica que la persona tenga permiso en ese workspace y envía una notificación en tiempo real a todos los que estén viendo esa lista en ese momento.”
Ese nivel de especificidad es la spec. El agente no es poco inteligente: simplemente no tiene contexto entre sesiones. Cada conversación empieza de cero. La spec es la única memoria que recibe.
El principio no se trata de simplificar de más. Obliga a que cada regla implícita salga a la luz. “Verificar permisos” es fácil de decir en una conversación. En una spec tienes que escribir: ¿qué permisos? ¿En qué operaciones? ¿Qué pasa si falla: rechazo silencioso o respuesta de error? ¿La verificación de permisos va antes o después de validar el input? Cada una es una pregunta que el agente va a responder de alguna forma. El principio es cómo controlas esas respuestas.
Sé específico, no genérico
Los requisitos vagos son donde los agentes alucinan alcance. La solución es la precisión.
Vago vs. ejecutable
| Vago: el agente adivina | Ejecutable: el agente sabe |
|---|---|
| "El sistema debe ser rápido." | GET /api/v1/tasks responde en menos de 500ms en p95 para listas de hasta 1.000 tareas. |
| "Valida el título." | Vacío → "Title is required"; 1 carácter → "Min 2 characters"; 501 caracteres → "Max 500". |
| "Maneja los errores con elegancia." | Si el proveedor da timeout, reintenta 3 veces con backoff exponencial y luego lo encola para revisión manual. |
| "La UI debe verse limpia." | La lista de tareas renderiza en menos de 200ms. Skeleton durante la carga. Estado vacío: "No tasks yet. Create one." |
La pregunta correcta para cada requisito: “Si le diera esta línea a alguien sin contexto, ¿podría implementarla sin hacer ninguna otra pregunta?” Si la respuesta es no, hazla más específica. Los adjetivos (rápido, limpio, seguro, robusto) no son requisitos. Son una invitación para que el agente los llene con sus propios supuestos.
Declara el alcance negativo
Lo que explícitamente no vas a construir importa tanto como lo que sí. Es la mejor defensa contra un agente que, “con toda la buena intención”, agrega features que nunca pediste.
Escríbelo como una lista simple, al principio del documento. Llama a la sección “Non-Goals” u “Out of Scope”. Sé directo:
## Non-Goals (v1)

- No recurring tasks
- No calendar integration (planned v2)
- No time tracking
- No task dependencies, subtasks only, max 50 per task
- No bulk operations (multi-select, bulk delete)
- No offline mode
Esta sección evita un tipo de error que es invisible hasta que sale caro: el agente extiende el modelo de datos para una feature que no querías, y ahora llevas tres horas refactorizando algo que nunca pediste construir.
Empecé a agregar una justificación de una línea a cualquier ítem que pueda parecer un olvido. “Sin registro de horas. El producto no compite en analytics.” Esa línea cierra un hueco que el agente podría llenar con la respuesta equivocada.
Los ejemplos concretos le ganan a los adjetivos
Las reglas de validación abstractas se implementan mal una y otra vez. Los ejemplos concretos, no.
No escribas “validar el título de la tarea de forma adecuada”. Escribe una tabla:
Campo de título: ejemplos de validación
| Input | Resultado esperado |
|---|---|
| "" (string vacío) | Error: "Title is required" |
| "A" (1 carácter) | Error: "Title must be at least 2 characters" |
| "Review PR #123" (válido) | Éxito: título guardado |
| "A" × 501 (501 caracteres) | Error: "Title must be 500 characters or fewer" |
| " " (solo espacios) | Error: "Title is required" (trim antes de validar) |
Esa última fila es la que muerde siempre. Ningún agente la va a agregar si no la agregas tú, porque nada en “validar el título de la tarea” implica hacer trim antes de validar. Los ejemplos concretos convierten la interpretación en verificación: el agente produce la salida exacta para ese input, o no.
Este patrón sirve para cualquier validación, cualquier máquina de estados, cualquier flujo condicional. Piensa en pares de input/output y escribe los pares. Es la forma más directa de especificar comportamiento.
Escribe requisitos EARS, no adjetivos
Los requisitos en lenguaje natural suenan razonables hasta que los implementas. “El sistema debe validar los permisos del workspace.” ¿En qué operaciones? Si falla, ¿rechaza en silencio o lanza un error? ¿Antes o después de validar el input?
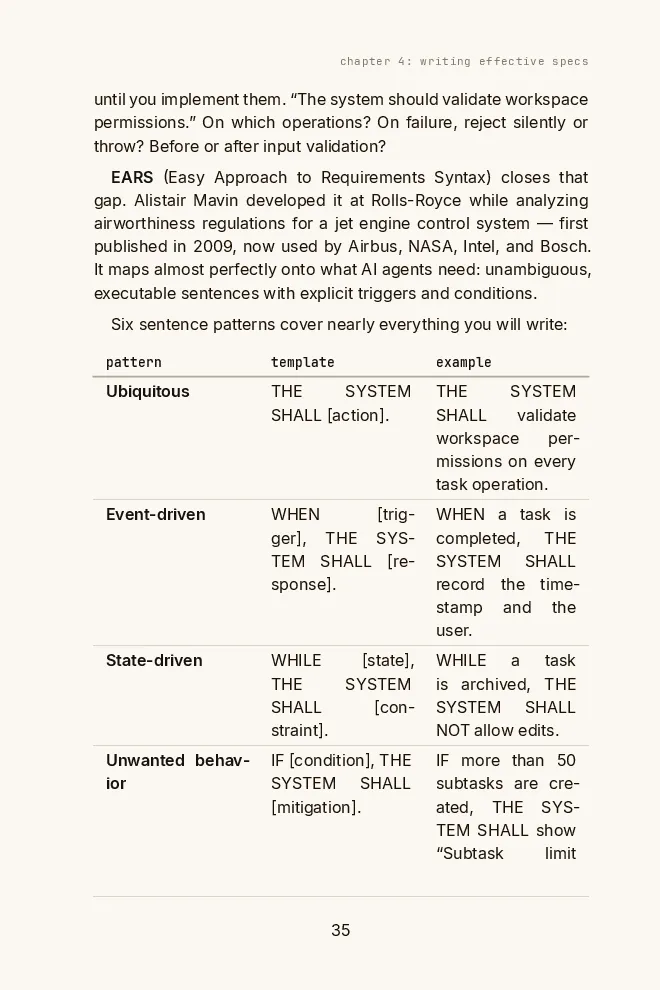
EARS (Easy Approach to Requirements Syntax) cierra ese hueco. Alistair Mavin lo desarrolló en Rolls-Royce PLC mientras analizaba regulaciones de aeronavegabilidad para el sistema de control de un motor a reacción. Se publicó por primera vez en 2009 y hoy lo usan Airbus, NASA, Intel y Bosch (según la página de EARS de Mavin). Encaja casi perfecto con lo que necesitan los agentes de IA: frases sin ambigüedad, ejecutables por una máquina, con disparadores y condiciones explícitos.
Kiro, el IDE agéntico de AWS, escribe su requirements.md exactamente en este formato: WHEN [condition/event] THE SYSTEM SHALL [expected behavior] (docs de Kiro, revisado el 13 de octubre de 2026). Aprende EARS una vez y podrás leer y editar lo que genera Kiro.
Los seis patrones de EARS
| Patrón | Plantilla | Ejemplo |
|---|---|---|
| Ubicuo | THE SYSTEM SHALL [acción]. | THE SYSTEM SHALL validar los permisos del workspace en cada operación sobre tareas. |
| Dirigido por eventos | WHEN [disparador], THE SYSTEM SHALL [respuesta]. | WHEN se completa una tarea, THE SYSTEM SHALL registrar el timestamp y el usuario que la completó. |
| Dirigido por estado | WHILE [estado], THE SYSTEM SHALL [restricción]. | WHILE una tarea está archivada, THE SYSTEM SHALL NOT permitir ediciones. |
| Comportamiento no deseado | IF [condición no deseada], THE SYSTEM SHALL [mitigación]. | IF se crean más de 50 subtareas, THE SYSTEM SHALL mostrar "Subtask limit reached" y rechazar la operación. |
| Opcional | WHERE [feature flag / config], THE SYSTEM SHALL [comportamiento]. | WHERE las notificaciones están activadas, THE SYSTEM SHALL notificar a todos los asignados cuando una tarea cambia de estado. |
| Complejo | WHEN [evento] AND [condición], THE SYSTEM SHALL [A] BEFORE [B]. | WHEN se completa una tarea AND hay una regla de automatización configurada, THE SYSTEM SHALL ejecutar la automatización BEFORE actualizar el estado de la tarea. |
No usas los seis en cada requisito. Elige el patrón según el tipo de requisito. Una invariante constante es Ubicuo. Una acción del usuario es Dirigido por eventos. Una condición de guarda es Dirigido por estado. Elige la plantilla, llena los huecos y la ambigüedad desaparece.
Una nota práctica sobre el vocabulario: EARS usa SHALL (comportamiento obligatorio) y SHALL NOT (comportamiento prohibido). Mapéalos directo a MoSCoW: SHALL = Must Have, SHOULD = Should Have, MAY = Could Have. No los suavices. “The system should validate permissions” no es el mismo requisito que “THE SYSTEM SHALL validate permissions.” El primero le da al agente una salida. El segundo, no.
La técnica del Implementation FAQ
Antes de que tu agente vea la spec, pregúntate: ¿qué va a tener que adivinar?
Lista cada ambigüedad y respóndela en la spec, en una sección explícita de preguntas y respuestas. Llámala “Implementation FAQ” u “Open Questions”. Cada hueco que sacas a la luz se convierte en una decisión que tomaste a propósito, y no en un supuesto equivocado metido en silencio en el código.
Así se ve para una feature de gestión de tareas:
## Implementation FAQ

**Q: What happens when a user tries to delete a task that has subtasks?**
A: Cascade delete all subtasks. Prompt for confirmation:
"This will also delete 3 subtasks. Continue?" Require explicit
confirmation before proceeding.

**Q: Who can see unassigned tasks?**
A: All members of the workspace, regardless of role. Only workspace
owners can assign tasks to others.

**Q: What happens if an assignee is removed from a workspace while they
have open tasks?**
A: Tasks remain open. The assignee field becomes null. A system
notification is sent to the workspace owner listing affected tasks.

**Q: Can a task belong to more than one project?**
A: No, one task belongs to exactly one project. This is a v1
constraint, not a design choice to revisit.

**Q: What timezone is used for due dates?**
A: Store as UTC. Display in the authenticated user's profile timezone.
If no timezone is set, display UTC with a "(UTC)" label.
Las entradas que más necesitas son las que quedan fuera del camino feliz: borrado en cascada, estados en conflicto, usuarios eliminados, zonas horarias, ediciones concurrentes. Son justo los casos que los agentes peor resuelven cuando los dejas adivinar, porque los datos de entrenamiento están saturados de implementaciones del camino feliz y casi vacíos de edge cases.
Escribo el FAQ imaginando al agente en plena implementación, llegando a un punto de decisión sobre el que la spec no dice nada. ¿Qué haría? Esa situación va al FAQ, con la respuesta correcta al lado.
Fija límites en tres niveles: siempre, pregunta antes, nunca
Los Non-Goals acotan el alcance. Los límites acotan el comportamiento del agente mientras trabaja. Las lecciones de GitHub con más de 2.500 archivos agents.md (Matt Nigh, noviembre de 2025) escriben los límites en tres niveles: siempre hazlo, pregunta antes, nunca lo hagas. Los mismos tres niveles van en una spec de feature, acotados a la feature.
Límites de mi prueba
| Nivel | Significado | Lo que decía la spec |
|---|---|---|
| Always (siempre) | Hazlo siempre, sin pedir permiso | Corre npm test antes de terminar y pega la línea de resumen. Mantén los montos como centavos enteros. |
| Ask first (pregunta antes) | Detente y pregunta antes de hacerlo | Cambiar la API pública de src/db.ts. Agregar una tabla o una unique constraint está bien. |
| Never (nunca) | Un alto total, sea cual sea el motivo | Agregar dependencias. Editar o borrar los tests existentes. Cambiar el GET /v1/charges/:id. |
La ejecución con spec respetó las tres líneas de Never. La ejecución de una línea no tenía límites y agregó sus cinco tests nuevos al archivo de tests existente. Inofensivo en un repo de juguete. En un repo donde ese archivo es de otro equipo, es el cambio que reviertes en el review.
Un detalle del “pregunta antes”: en una ejecución headless nadie responde. Di qué debe hacer el agente en su lugar (detenerse y reportar, o elegir y avisar), o el nivel no significa nada.
Deja que el agente te entreviste y empieza de cero
No tienes que escribir el primer borrador solo. Las Claude Code best practices de Anthropic ahora lo dicen sin vueltas: en features grandes, pídele a Claude que te entreviste y escriba una spec y, “cuando la spec esté completa, empieza una sesión nueva para ejecutarla”. La sesión nueva tiene contexto limpio y una spec escrita como referencia.
El ciclo de dos sesiones
Empieza con un prompt mínimo y pide que te entrevisten.
El agente lee el repo y pregunta por las partes difíciles antes de escribir una línea. Este es el prompt de Anthropic, palabra por palabra.
Escribe esto
I want to build [brief description]. Interview me in detail using the AskUserQuestion tool. Ask about technical implementation, UI/UX, edge cases, concerns, and tradeoffs. Don't ask obvious questions, dig into the hard parts I might not have considered. Keep interviewing until we've covered everything, then write a complete spec to SPEC.md.
Revisa la spec y constrúyela en una sesión nueva.
La entrevista llena el contexto de exploración. La construcción recibe una ventana limpia y el archivo.
En lugar de
Ahora constrúyelo. (misma sesión, contexto lleno)
Escribe esto
Implement the spec in spec/<feature>/. Follow it exactly.
Corrí el paso de entrevista en el mismo repo inicial, en una sesión headless nueva que no había visto ninguna de las construcciones, con una variante de ese prompt: “Before anyone writes code, interview me: read the repo, then ask me the questions you need answered to write a spec for this feature, most important first.” Headless, así que listó sus preguntas en vez de hacerlas de a una, y nadie las respondió: 12 preguntas en 13 segundos, por US$ 0,056. Primero leyó el código y notó que el almacén en memoria cede el turno entre llamadas, así que un check-then-insert tendría una carrera. Después preguntó por las decisiones que mi spec ya había tomado:
Preguntas que hizo el agente (resumidas)
| El agente preguntó | Mi spec decidió | La ejecución de una línea adivinó |
|---|---|---|
| Replay: ¿el mismo 201 o un 200? ¿Un header que lo marque? | 200 + Idempotent-Replayed: true | 201, con el header |
| Misma clave, otro body: ¿rechazar? ¿422 o 409? | 422, mensaje exacto | 422, otro mensaje |
| Un duplicado con el primero todavía en curso: ¿409 o esperar? | 200 con el cobro del ganador | 409 + Retry-After |
| ¿Una petición fallida (422) consume la clave? | No, la clave queda libre | No (igual) |
| ¿El header es opcional u obligatorio? | Opcional; sin header, el comportamiento de hoy | Opcional (igual) |
| ¿Largo máximo de la clave? ¿400 o 422 si es inválida? | 1-255 caracteres, 400 | 1-255 caracteres, 422 |
| ¿Claves para siempre o expiran en algo como 24 horas? | 24 horas desde el createdAt | Para siempre |
El agente es bueno encontrando las decisiones y no tiene cómo saber tus respuestas. Responde sus preguntas y tienes buena parte del Implementation FAQ y de la tabla de aceptación.
Del SRS a la spec para agentes de IA
Quien busca una “plantilla de spec” o una “especificación de requisitos de software” normalmente está resolviendo un problema de coordinación entre personas. Quiere un documento que alinee al equipo, consiga la aprobación de los stakeholders y sobreviva a un traspaso. El formato clásico de SRS del IEEE-830, con introducción, alcance, requisitos funcionales, requisitos no funcionales, especificaciones de interfaz y restricciones, se diseñó justo para eso. Y lo resolvió bastante bien.
El trabajo cambia cuando quien lee la spec es un agente de IA.
Un equipo humano arrastra contexto de una reunión a otra. Hace preguntas antes de empezar. Nota cuando algo se ve raro y te consulta. Un agente de IA no hace nada de eso. Empieza cada sesión sin ningún recuerdo de las conversaciones que tuvieron, sin memoria de las decisiones que tomaste la semana pasada y sin intuición alguna sobre tus reglas de negocio implícitas. Todo lo que el agente necesita saber tiene que estar en el documento.
La especificación de requisitos de software clásica tenía cinco secciones principales: introducción, descripción general, requisitos funcionales, requisitos no funcionales e interfaces externas. Los equipos las escribían en prosa, organizada por feature. Esa estructura sigue siendo el esqueleto correcto. Lo que cambia con los agentes de IA no es la forma, sino los supuestos que hay debajo.
Un SRS tradicional podía contar con contexto compartido. Cada ingeniero del equipo había estado en las sesiones de planificación. Conocía la historia del producto. Hacía preguntas en la daily. El conocimiento implícito no hacía falta escribirlo porque vivía en la cabeza de la gente. Un agente de IA no tiene nada de eso. Si tu spec dice “validar permisos”, el agente no puede preguntarte qué quisiste decir. Adivina y sigue.
Tres cambios hacen que el SRS sea ejecutable por un agente, y no solo legible por un equipo.
Primero, EARS cierra la ambigüedad a nivel de frase, algo que el IEEE-830 nunca abordó. El estándar decía que “los requisitos deben ser inequívocos”. EARS te da la gramática para imponerlo frase por frase: WHEN, WHILE, IF, WHERE, SHALL.
Segundo, el alcance negativo te protege de agregados plausibles. Un equipo humano sabe lo que no está construyendo porque estuvo en la sala cuando se tomó la decisión. El agente no estuvo. Una sección “Out of Scope” explícita es obligatoria, no opcional.
Tercero, una línea final de “Confirm before building” frena a un agente ansioso antes de que se lance al código sin verificar lo que entendió. Terminas la spec pidiéndole al agente que reformule los requisitos clave con sus propias palabras antes de escribir un solo carácter de código. Si entendió algo mal, te enteras a costo cero, no después de tres sesiones de implementación.
Todo lo demás del SRS clásico, los IDs de trazabilidad, los criterios de aceptación, la sección de restricciones, la tabla de riesgos, se transfiere tal cual. La estructura estaba bien. Cambió el lector.
Una spec que nunca puede cobrar dos veces
La mejor forma de ver cómo se combinan estas técnicas es un caso real y difícil. Esto es muy parecido a la spec que escribí para la fintech cripto: un endpoint de cobro en el que un reintento nunca puede cobrarle dos veces al cliente.
# Spec: Create a payment charge (POST /v1/charges)
# Status: requirements:approved

## Overview
A merchant creates a charge against a customer. This moves money, so it
must be safe to retry and impossible to double-bill.

## In scope
- Create a charge from an authenticated merchant request.
- Return the charge id and status.
- Guarantee exactly-once billing under client retries.

## Out of scope (v1)
- Refunds (separate spec: 005-refunds).
- Partial captures.
- Multi-currency. All amounts are BRL, stored as integer cents. Never float.

## Functional requirements (EARS)
- FR-1  WHEN a merchant POSTs a charge with a valid Idempotency-Key,
        THE SYSTEM SHALL create at most one charge for that key.
- FR-2  WHEN the same Idempotency-Key is replayed within 24h,
        THE SYSTEM SHALL return the original charge and create no new one.
- FR-3  IF the amount is <= 0,
        THE SYSTEM SHALL reject with 422 "amount must be positive".
- FR-4  IF the merchant is over its rate limit,
        THE SYSTEM SHALL reject with 429 and a Retry-After header.
- FR-5  WHILE a charge is pending,
        THE SYSTEM SHALL NOT allow a second capture.

## Acceptance criteria (examples the agent must satisfy)
- amount=1000, key=abc            -> 201, status=pending
- same key=abc, replayed          -> 200, same charge id, no new row
- amount=0                        -> 422 "amount must be positive"
- amount=-50                      -> 422 "amount must be positive"
- 6th request in 1s, one merchant -> 429, Retry-After: 1

## Non-functional
- p95 latency under 300ms at 200 requests/sec per merchant.
- Every money value is an integer. No floating point anywhere in the path.

## Data
- charges(id, merchant_id, amount_cents, currency, status,
          idempotency_key, created_at)
- UNIQUE(merchant_id, idempotency_key)   # this is what enforces FR-1

## Verification
- Integration test replays one key 50x concurrently; assert exactly one
  row and one ledger entry.
- Load test holds p95 < 300ms at 200 rps.
- Paste the test output. "Should pass" is not evidence.

## Confirm before building
Do not write code until you restate FR-1 through FR-5 and the uniqueness
constraint in your own words. If any acceptance criterion is ambiguous,
ask before implementing.
Veamos por qué cada parte se gana su lugar.
“Out of scope” nombra lo que esta spec no cubre. Sin eso, el agente podría extender la tabla de cobros con una columna refund_amount porque los reembolsos parecen relacionados. Son columnas extra, archivos de migración y un modelo de datos ahora acoplado a una feature que todavía no especificaste.
FR-1 y FR-2 juntos especifican la idempotencia desde los dos lados: al recibirlo por primera vez, crea un cobro; en el replay, devuelve el original. Decirlo dos veces cierra el hueco en ambas direcciones. Una sola frase EARS no alcanza aquí, porque las dos situaciones (primera llamada vs. llamada repetida) producen respuestas HTTP distintas.
FR-3 y FR-4 son el patrón de “comportamiento no deseado”. Especifican lo que el sistema tiene que hacer cuando algo sale mal. Sin ellos, el agente elige sus propias respuestas de error. A veces 400, a veces 500, a veces nada.
La sección de criterios de aceptación no es un archivo de tests. Es una tabla de pares input/output que vive en la spec para que el agente verifique su propio trabajo antes de que tú revises nada. Cada fila es una comprobación que el agente puede ejecutar.
“Every money value is an integer. No floating point anywhere in the path.” Esa sola frase evita el error de redondeo de punto flotante que le pega a un sistema de pagos al segundo día en producción. Vive en la spec y no en un comentario de código, porque los comentarios no sobreviven al cambio de sesión.
La constraint UNIQUE del modelo de datos es lo que de verdad garantiza el FR-1. Si la dejas fuera, el agente puede implementar la idempotencia en la lógica de la aplicación. La lógica de la aplicación falla con reintentos concurrentes. La constraint de la base de datos, no.
“Confirm before building” es la última línea. El agente reformula FR-1 a FR-5 con sus propias palabras antes de escribir un carácter de código. Si entendió mal el FR-2, te enteras ahora, a costo cero. Sáltate esa línea y te enteras después de la implementación.
Ese es el gate de entrada. El gate de salida es la evidencia. La guía de Anthropic lo pide directamente: que Claude “muestre evidencia en vez de afirmar que funcionó”. La última línea de Verification dice lo mismo. En mi prueba, la ejecución con spec cerró con # tests 14, # pass 14, # fail 0 porque su spec pedía la salida. La ejecución de una línea escribió que los 9 tests pasaban y no mostró ninguno.
Tres documentos, no uno
La spec de una feature real no es un documento. Son tres, y tienen un orden estricto.
Carpeta de spec de la feature
- spec/
- tasks-feature/
- .statusgaterequirements:draft → approved, design:draft → approved, tasks:draft → approved
- requirements.mdQUÉ: aprobado antes de que empiece el diseño
- design.mdCÓMO: aprobado antes de que empiecen las tareas
- tasks.mdCUÁNTO: aprobado antes de que empiece la implementación
El archivo .status es el gate. El agente lo lee al inicio de cada sesión. Si dice requirements:draft, no avanza ningún trabajo de diseño. Cada documento forma parte de una cadena de dependencias: el diseño mapea a los requisitos, las tareas mapean al diseño. Si escribes los tres de una vez sin los gates de aprobación, te queda un waterfall. Con los gates, tienes iteración deliberada, donde cada fase se cierra antes de que se abra la siguiente.
requirements.md: QUÉ
Es el documento que escribes primero y el único que le pasas a un stakeholder no técnico para revisar. Se mantiene independiente de la tecnología.
Secciones: Overview, Goals, Non-Goals, User Stories (US-001…) con criterios de aceptación, Functional Requirements (FR-001… en EARS con prioridad MoSCoW), Non-Functional Requirements (NFR-001…), Constraints, Decisions (D-001…), Implementation FAQ (Q-001…), Success Metrics, Risks.
Estos IDs (US-001, FR-001, NFR-001, D-001) son cómo el diseño se conecta con los requisitos, cómo las tareas se conectan con el diseño y cómo respondes “¿por qué existe este código?” seis meses después sin leer toda la codebase. Nunca te los saltes.
design.md: CÓMO
Es el documento técnico. Cada requisito funcional tiene que tener una decisión de diseño correspondiente. Si un requisito no mapea al diseño, o el diseño está incompleto, o el requisito no hace falta implementarlo.
Secciones: Executive Summary (la arquitectura en dos frases), Requirements Mapping (tabla explícita: a qué sección del diseño mapea el FR-001), System Architecture, Data Model, API Contract, Edge Cases, Testing and Verification Strategy, Technical Decisions (TD-001… con alternativas consideradas y justificación), Risks.
La tabla de mapeo de requisitos es la sección más importante y la que más se salta. Obliga a una comprobación: cada FR tiene que tener un lugar en el diseño. Cualquier FR sin mapeo es un hueco, y un hueco en el diseño es un hueco en el código.
tasks.md: CUÁNTO
Es lo que el agente implementa, una tarea a la vez. Las tareas duran entre 2 y 4 horas cada una. Lo que sea más grande se divide.
Secciones: Requirement Coverage (trazabilidad de FR a tareas), Implementation Readiness Check (un gate de pasa/no pasa: ¿están aprobados los requisitos y el diseño? ¿están respondidos todos los ítems Q-001?), Tasks, cada una con título, referencia al requisito (FR-003), archivos que toca, tamaño estimado, dependencias de otras tareas, criterios de aceptación y comandos de verificación.
Los criterios de aceptación de cada tarea son lo que el agente ejecuta para verificar su propio trabajo antes de marcar la tarea como terminada. Si no están, el agente declara victoria según le parezca que el código se ve bien, no según si realmente funciona.
La plantilla de requirements.md
Ponla en la carpeta de la feature, completa cada sección y pásasela al agente. Es la estructura exacta que uso en cada feature.
# [Feature Name], Requirements

**Status:** draft
**Version:** 1.0
**Author:** [name]
**Date:** [YYYY-MM-DD]

---

## Overview

[One paragraph: what this feature does, why it exists now, and who it's for.]

## Goals

- [Measurable goal 1, e.g., "Users can create and assign tasks in under 30 seconds."]
- [Measurable goal 2]
- [Measurable goal 3]

## Non-Goals (v1)

- [Thing you will NOT build, be explicit]
- [Another thing out of scope, add rationale if the omission might look like a mistake]
- [Third item]

## User Stories

### US-001: [Story title]

**As a** [persona],
**I want to** [action],
**so that** [benefit].

**Acceptance criteria:**

- [ ] [Observable, testable criterion]
- [ ] [Observable, testable criterion]
- [ ] [Edge case criterion]

### US-002: [Story title]

[Repeat structure]

---

## Functional Requirements

### FR-001, [Requirement name] [Must Have]

THE SYSTEM SHALL [specific, unambiguous behavior].

**Priority:** Must Have
**User story:** US-001
**Notes:** [Any clarification or related constraint]

### FR-002, [Requirement name] [Must Have]

WHEN [trigger], THE SYSTEM SHALL [response].

**Priority:** Must Have
**User story:** US-001

### FR-003, [Requirement name] [Should Have]

WHILE [state], THE SYSTEM SHALL NOT [prohibited action].

**Priority:** Should Have
**User story:** US-002

### FR-004, [Requirement name] [Must Have]

IF [unwanted condition], THE SYSTEM SHALL [mitigation].

**Priority:** Must Have
**User story:** US-001

### FR-005, [Requirement name] [Could Have]

WHERE [feature flag / config], THE SYSTEM SHALL [behavior].

**Priority:** Could Have
**User story:** US-002

### FR-006, [Requirement name] [Must Have]

WHEN [event] AND [condition], THE SYSTEM SHALL [A] BEFORE [B].

**Priority:** Must Have
**User story:** US-001

[Continue with FR-007, FR-008...]

---

## Non-Functional Requirements

### NFR-001, Performance

THE SYSTEM SHALL respond to [specific endpoint or operation] in under
[X]ms at p95 for [load condition, e.g., "lists up to 1,000 tasks"].

### NFR-002, Security

THE SYSTEM SHALL [specific security behavior, e.g., "validate a signed
JWT on every mutation before any business logic runs"].

### NFR-003, Accessibility

THE SYSTEM SHALL meet WCAG 2.1 AA for all new UI components in scope.

---

## Constraints

- **Technology:** [e.g., "Must use the existing PostgreSQL instance, no new databases."]
- **Timeline:** [e.g., "Must ship before [date] to support [event]."]
- **Compliance:** [e.g., "All PII fields must be encrypted at rest."]
- **Integration:** [e.g., "Must call the existing notification service via its current API, no schema changes."]

---

## Boundaries

- **Always:** [e.g., "Run the test suite before finishing and paste the summary line."]
- **Ask first:** [e.g., "Changing a public API or a shared module." Say what to do when nobody answers.]
- **Never:** [e.g., "Add dependencies. Edit existing tests. Touch files outside src/tasks/."]

## Commands

- **Test:** `[npm test]`
- **Lint / typecheck:** `[npm run lint]`
- **Files to start from:** `[src/tasks/service.ts]`, `[src/tasks/schema.ts]`

---

## Decisions

### D-001: [Decision title]

**Decision:** [What was decided]
**Rationale:** [Why, include what problem it solves]
**Alternatives considered:** [What else was evaluated and why it was rejected]
**Date:** [YYYY-MM-DD]

---

## Implementation FAQ

**Q: [Anticipated ambiguity 1, focus on edge cases and deletion behavior]**
A: [Explicit answer, no hedging, no "it depends"]

**Q: [Anticipated ambiguity 2, conflicting states, concurrent operations]**
A: [Explicit answer]

**Q: [Access / visibility edge case]**
A: [Explicit answer, who sees what under which conditions]

**Q: [Timezone / locale / formatting question if relevant]**
A: [Explicit answer, specify storage format and display format separately]

---

## Success Metrics

- [ ] [Metric 1, e.g., "P95 latency for task list under 500ms in staging under 1,000-task load."]
- [ ] [Metric 2, user-observable outcome if no instrumentation exists]
- [ ] [Metric 3]

---

## Verification evidence

- [The end-to-end check that proves the feature works, e.g., "50 concurrent
  requests with one key create exactly one row."]
- Paste the command you ran and its output. "Should pass" is not evidence.

---

## Risks

| Risk     | Likelihood       | Impact           | Mitigation   |
| -------- | ---------------- | ---------------- | ------------ |
| [Risk 1] | Low / Med / High | Low / Med / High | [Mitigation] |
| [Risk 2] |                  |                  |              |
Libro gratis · en inglés · 169 páginas
Una spec completa son tres archivos: requirements.md, design.md y tasks.md. El libro trae las tres plantillas y skills de Claude Code para cada fase, listas para copiar.
Dónde vive esta spec en Kiro, Spec Kit y OpenSpec
La plantilla no depende de la herramienta. Toda herramienta de specs la divide igual en tres partes, QUÉ, CÓMO y la lista de tareas, con nombres de archivo distintos. Si cambias de herramienta, este es el mapa:
La misma spec, cuatro casas
| Herramienta | Requisitos (QUÉ) | Diseño (CÓMO) | Tareas | Gate |
|---|---|---|---|---|
| Kiro | requirements.md en EARS (bugfix.md para bugs) | design.md | tasks.md | Aprobación entre fases; Quick Spec se salta los gates |
| Spec Kit 1.0.13 | specs/001-feature/spec.md, más un constitution.md de todo el repo | plan.md | tasks.md | Una skill por fase; tú corres cada una |
| OpenSpec 1.14.1 | openspec/changes/<name>/proposal.md + un delta de la spec | design.md | tasks.md | El archive aplica el delta en openspec/specs/ |
| Claude Code, sin kit | spec/<feature>/requirements.md | design.md | tasks.md | El archivo .status; el agente lo lee en cada sesión |
Mi prueba usó la última fila: tres archivos y un .status, sin herramienta instalada. Si quieres esa carpeta con los gates garantizados por skills en lugar de disciplina, claude-sdd-kit es el que uso en Claude Code. Las guías a fondo: qué es Kiro, GitHub Spec Kit 1.0, OpenSpec de la instalación al archive y los tres comparados.
AGENTS.md no es la spec
El AGENTS.md (o el CLAUDE.md) guarda lo que vale para cualquier tarea del repo: los comandos, las convenciones, los límites que nunca cambian. La spec guarda lo que vale para una feature: sus requisitos, sus Non-Goals, sus chequeos de aceptación. Mete reglas de una feature en el AGENTS.md y cada sesión las paga en contexto, mucho después de que la feature salió a producción. Mete reglas del repo en cada spec y se desincronizan. Cuando un límite aparece en tres specs seguidas, súbelo al AGENTS.md.
Antes de pasarle la spec al agente
Gate de preparación de la spec
- Pasa el principio de la niña lista: alguien sin contexto puede construir lo correcto a partir de esto.Si tendrías que explicar de palabra algo que no está en el documento, el documento no está terminado.
- Cada requisito funcional está en formato EARS.Si escribiste 'debe ser rápido' o 'manejar los errores con elegancia', búscalo y reemplázalo.
- Los Non-Goals son explícitos: al menos 3 cosas que no vas a construir.La ausencia de una sección de Non-Goals es un riesgo de alcance, no una spec limpia.
- Las reglas de validación tienen tablas de ejemplos de input/output.Las reglas de validación en prosa casi siempre quedan subespecificadas. Las tablas cierran el hueco.
- Todas las User Stories tienen criterios de aceptación testeables.Si un criterio no se puede testear de forma independiente, es un objetivo vago, no un requisito.
- Existen IDs estables y únicos: US-001, FR-001, NFR-001, D-001.Los vas a referenciar en design.md y tasks.md. Sin IDs, se rompe la trazabilidad.
- El Implementation FAQ cubre los 3 edge cases principales.Como mínimo: el borrado en cascada, el escenario de estados en conflicto y cualquier edge case de control de acceso.
- Los requisitos de rendimiento tienen números, no adjetivos.'Rápido' no es un requisito. '500ms en p95 para listas de hasta 1.000 tareas' sí lo es.
- La spec termina con una línea de 'Confirm before building'.El agente reformula los requisitos clave con sus propias palabras antes de escribir código. Si entendió algo mal, te enteras ahora, no después.
- El archivo .status dice 'requirements:draft' hasta que lo revises y lo apruebes.Draft no es aprobado. El agente no debe pasar al diseño con una spec en draft.
- Los requisitos no funcionales cubren rendimiento, seguridad y accesibilidad.Son las tres secciones que más faltan en los primeros borradores.
- Los límites están en tres niveles: siempre, pregunta antes, nunca.El nunca lista los cambios que revertirías en el review. El pregunta antes dice qué hacer cuando nadie responde.
- La verificación pide evidencia: el comando y su salida.Un agente que solo dice 'todos los tests pasan' no te mostró nada. Pegar la salida es parte de terminar.
FAQ
¿Qué tan largo debe ser un requirements.md?
Lo bastante largo para evitar supuestos equivocados y lo bastante corto para que se siga manteniendo. Una feature típica de producción queda entre 400 y 800 líneas, contando el boilerplate de la plantilla.
Si pasas de 1.000 líneas, pregúntate si es una feature o dos. Si estás por debajo de 200, pregúntate si de verdad respondiste las preguntas difíciles o solo escribiste las preguntas.
¿Necesito los tres documentos para cada feature?
Para un script descartable o un arreglo de dos horas, no. Manda el prompt y listo. El overhead no vale la pena.
Para cualquier cosa que abarque varias sesiones, implique decisiones reales de arquitectura o maneje datos que no puedes reescribir fácilmente, los tres se pagan solos. El design.md evita los errores más caros; el tasks.md evita el mayor desperdicio de esfuerzo de implementación.
¿Cuál es la diferencia entre Non-Goals y Constraints?
Los Non-Goals son features que eliges no construir en esta versión: 'sin tareas recurrentes'. Las Constraints son los límites dentro de los que tienes que trabajar: 'hay que usar la base de datos existente, sin servicios nuevos'.
Los Non-Goals protegen el alcance. Las Constraints le dan forma al espacio de soluciones. Ambos van en los requisitos, en secciones separadas.
¿Puedo usar esta plantilla con agentes que no sean Claude Code?
Sí. El formato es markdown plano. Cualquier agente que pueda leer archivos se beneficia de esta estructura: Cursor, Copilot, GPT-4o en un custom GPT, Gemini. La sintaxis EARS y los IDs estables no dependen del modelo.
El archivo de gate .status es propio del workflow de SDD que uso, pero los documentos en sí funcionan con cualquier agente capaz.
Mi equipo escribe specs en Confluence o Notion. ¿Tengo que pasarme a archivos markdown?
No necesariamente. El valor está en la estructura y el contenido, no en el formato. Puedes escribir una spec en Notion y pegarla en el contexto del agente al inicio de cada sesión.
La razón por la que uso archivos markdown en el repo es la trazabilidad: la spec vive al lado del código que gobierna, se versiona en git junto con él y el agente la lee directamente, sin copiar y pegar. Ese último punto importa más de lo que parece. La fricción es lo que hace que las specs se salten.
¿Cómo manejo un requisito que cambia a mitad de la implementación?
Actualiza el requirements.md, agrega una nota de cambio con la fecha, vuelve a poner el .status en 'requirements:draft' y apruébalo de nuevo antes de que el agente continúe.
La disciplina es: nunca dejes que el agente implemente a partir de una spec que no volviste a leer desde el cambio. Un requisito modificado que no se propaga al diseño crea una contradicción entre lo que hace el código y lo que dice la spec. Tu yo del futuro va a tener que desenredarlo en frío.
¿Y si no sé todas las respuestas cuando escribo la spec?
Escribe lo que sí sabes y pon las preguntas abiertas de forma explícita en la sección de Implementation FAQ, marcadas como abiertas, no respondidas. Sigue siendo mejor que el silencio, porque el agente ve la pregunta y sabe que tiene que preguntar en vez de adivinar.
Después resuélvelas antes de aprobar la spec. Una pregunta abierta en una spec aprobada es un bug diferido.
¿Qué son los requisitos EARS?
EARS (Easy Approach to Requirements Syntax) es una forma de escribir cada requisito como una frase de estructura fija: un disparador o condición opcional (WHEN, WHILE, IF, WHERE) seguido de THE SYSTEM SHALL y la respuesta. Alistair Mavin y sus colegas lo desarrollaron en Rolls-Royce; se publicó por primera vez en 2009.
Para un agente de IA, la estructura fija le quita espacio para adivinar: cada requisito dice cuándo aplica y qué tiene que pasar. Kiro escribe su requirements.md en EARS por defecto.
¿Cuánto tiempo debería dedicarle a escribir una spec?
No cronometré la mía. La spec de mi prueba tuvo 151 líneas de markdown en tres archivos para un endpoint. El paso de entrevista es el atajo: en una ejecución aparte generó 12 preguntas en 13 segundos, y cubrieron todas las decisiones que mi spec había tomado. Responderlas es buena parte de la escritura.
Lo que compró la spec: 14 de 14 chequeos de aceptación contra 8 de 14 de un prompt de una línea, por US$ 0,021 más de costo de agente.
¿Cómo escribo una spec para código existente?
La misma plantilla, con dos agregados. Nombra los archivos desde donde parte el cambio (la sección Commands) y agrega un Non-Goal por cada comportamiento que no puede cambiar. Las specs de bugfix de Kiro lo hacen explícito con una línea WHEN [condition] THEN the system SHALL CONTINUE TO [existing behavior].
Corre primero el paso de entrevista: el agente lee el repo antes de preguntar, así encontró la carrera en mi repo de prueba. Para sistemas legados grandes, la guía de AI-DLC en brownfield de este sitio cubre cómo hacer ingeniería inversa de la spec primero.
¿AGENTS.md es lo mismo que una spec?
No. El AGENTS.md (o el CLAUDE.md) se carga en cada sesión y guarda lo que vale para todo el repo: comandos, convenciones, límites permanentes. Una spec guarda una feature: requisitos, Non-Goals, chequeos de aceptación. Deja las reglas de una feature fuera del AGENTS.md; cuestan contexto en cada sesión después de que la feature sale a producción.
¿Cómo compruebo que el agente siguió la spec?
Escribe los chequeos de aceptación antes de construir y córrelos tú. En mi prueba, 14 tests escritos antes de las dos construcciones fueron el juez, y el agente nunca vio el archivo de tests. Una suite que escribiste tú es más difícil de engañar que una que el agente escribió junto con el código.
Después pide evidencia, no afirmaciones: el comando de test y su salida. La guía de Anthropic suma un paso de review en un subagent nuevo que compara el diff con el plan y reporta los huecos.
¿Una spec sigue ayudando con un modelo fuerte?
Sí, pero no como la gente espera. En mi prueba, el prompt de una línea acertó la parte difícil: ningún cobro doble con 50 reintentos concurrentes. Lo que no podía acertar eran las decisiones que solo yo podía tomar: status codes, la ventana de expiración, qué recibe un duplicado en curso.
Un modelo fuerte recorta los bugs que vienen de un malentendido. Las decisiones siguen siendo tuyas, y la spec es donde las escribes.
Por dónde seguir
Una buena spec lleva entre 30 y 90 minutos de escritura para una feature típica. Ese tiempo vuelve en la primera sesión de implementación: lo dedicas a problemas que son difíciles de verdad, no a depurar requisitos mal entendidos.
¿Escribes specs para un equipo en vez de para ti? Spec-Driven Development para equipos cubre el flujo de spec compartida, y AI-DLC vs Spec-Driven Development es el siguiente peldaño. ¿Vas a especificar un cambio en código legado? AI-DLC en brownfield empieza por la ingeniería inversa de lo que el sistema hace hoy.
Libro gratis · en inglés · 169 páginas
Aprende a escribir specs y llévate plantillas de requirements en EARS, design y tasks. El libro, en inglés, las aplica en un proyecto real.
Recibir el libro gratis