Como escrever uma spec para agentes de IA: template, formato EARS e exemplos
Como escrever uma spec que um agente de IA consegue construir: template para copiar, requisitos EARS, limites em três níveis, a etapa de entrevista e um teste real de um prompt de uma linha contra a spec.
Uma spec só é boa se alguém sem nenhum do seu contexto consegue ler e construir a coisa certa. Esse teste é o trabalho inteiro.
Uma spec que um agente de IA consegue construir é um arquivo markdown autocontido. Ela nomeia os arquivos e as interfaces, lista o que está fora do escopo, escreve cada requisito como uma frase EARS testável (WHEN [gatilho], THE SYSTEM SHALL [resposta]) com exemplos de entrada e saída, define limites em três níveis (sempre, pergunte antes, nunca) e termina com um passo de verificação que prova que a feature funciona. Peça para o agente te entrevistar para rascunhar a spec e depois construa numa sessão nova.
Eu testei isso em 13 de outubro de 2026. Uma feature de pagamentos, construída duas vezes pelo Claude Code com o mesmo modelo: uma a partir de um prompt de uma linha, outra a partir deste template. A execução de uma linha passou em 8 de 14 checagens de aceite e a execução com spec passou em 14 de 14. As duas criaram exatamente uma cobrança com 50 retries concorrentes. O setup e todos os números estão abaixo.
A Anthropic diz qual é o alvo sem rodeios nas Claude Code best practices: “as specs mais úteis são autocontidas: nomeiam os arquivos e as interfaces envolvidas, dizem o que está fora do escopo e terminam com um passo de verificação ponta a ponta que prova que a feature funciona.” Essa é a régua. O resto deste texto é como passar por ela.
A maioria de quem experimenta Spec-Driven Development já entende o porquê. Leu o que é Spec-Driven Development, acredita que a spec é o artefato certo para entregar a um agente de IA e aí abre um arquivo em branco e escreve: “O sistema deve lidar com a autenticação de usuários de forma segura.” Depois não entende por que o resultado continua errado.
O problema não é falta de compromisso. Escrever uma boa spec é uma habilidade à parte, e quase nada ensina isso. Este artigo cobre um teste medido, o teste de qualidade de uma spec, o formato de frase que fecha a ambiguidade, o que você precisa excluir explicitamente, os limites e a etapa de entrevista, um exemplo completo de uma fintech real e um template para copiar e colar.
Este é o complemento prático de Spec-Driven Development com Claude Code e do estudo de caso que mostra o que esses documentos produzem em escala.
Livro gratuito · 177 páginas · PDF + EPUB
Escrever spec é uma habilidade que quase ninguém ensina, e menos ainda em português. O livro ensina num projeto real, de requisitos em EARS até design e tasks.
Receber o livro gratuitoEu testei: prompt de uma linha vs spec, mesmo agente
Afirmação sobre spec é barata. Então construí a mesma feature duas vezes e medi as duas execuções.
A feature é a do exemplo de pagamento mais abaixo: tornar o POST /v1/charges idempotente, para que uma requisição repetida nunca cobre o cliente duas vezes. Escolhi essa porque ela tem edge cases de verdade: retries concorrentes, um replay com outro valor, uma chave que expira e uma requisição que falha na validação antes de valer.
Setup
| Item | As duas execuções |
|---|---|
| Data | 13 de outubro de 2026 |
| Agente | Claude Code 2.1.296, headless: claude -p --output-format json, modo de permissão bypassPermissions (ninguém para perguntar), sem MCP servers, sem configurações de usuário |
| Modelo | Claude Sonnet 5.5 (claude-sonnet-5-5) nas duas |
| Repo | Uma API de cobranças mínima: 247 linhas de TypeScript em Node 22, zero dependências, 4 testes, um banco assíncrono em memória com unique constraints. Mesmo commit inicial para as duas. |
| Entrada da execução de uma linha | "Add idempotency key support to POST /v1/charges so client retries never double-charge a customer." |
| Entrada da execução com spec | O template deste artigo: requirements.md (8 requisitos EARS, Non-Goals, tabela de aceite, Implementation FAQ, Boundaries, Verification), design.md, tasks.md: 151 linhas de markdown, mais um arquivo .status. |
| Juiz | 14 testes de aceite que escrevi antes das duas execuções, guardados fora dos dois repos. O agente nunca os viu. O código sem mudança passa em 4 de 14. |
Mesma feature, mesmo modelo, duas entradas
- Spec: checagens aprovadas
- 14/14
- Prompt de uma linha: 8/14
- Cobrança em 50 retries concorrentes
- 1
- Nas duas execuções
- Custo da execução com spec
- US$ 0,119
- Prompt de uma linha: US$ 0,098 (+21%)
- Tokens da execução com spec
- 91,7k
- Prompt de uma linha: 83,3k (+10%)
- Tempo de agente da execução com spec
- 31 s
- Execução de uma linha: 25 s
Nem toda checagem é justa com um prompt de uma linha, então dividi as 14 em três grupos antes de rodar qualquer coisa:
Resultado por grupo
| Grupo | O que checa | Prompt de uma linha | Spec |
|---|---|---|---|
| Segurança (5) | O replay devolve a mesma cobrança; 50 requisições concorrentes geram uma cobrança e todas têm sucesso; chaves por merchant; requisições sem chave continuam iguais; nenhum campo interno vaza | 4/5 | 5/5 |
| Julgamento (3) | Rejeitar chave reusada com outro valor; requisição que falhou não queima a chave; rejeitar uma chave de 10.000 caracteres | 3/3 | 3/3 |
| Decisões da spec (6) | 201 e depois 200 no replay; o header de replay; a mensagem exata do 422; 400 para chave inválida; um replay em 23h59 devolve 200; um replay depois de 24 horas cria uma cobrança nova | 1/6 | 6/6 |
O que o prompt de uma linha acertou
Mais do que eu esperava. Ele reservou a chave com uma unique constraint antes de criar a cobrança, então 50 retries concorrentes geraram exatamente uma cobrança. Rejeitou chave reusada com outro valor, deixou a chave livre depois de uma requisição que falhou, limitou o tamanho da chave e até chamou o header de replay de Idempotent-Replayed, o mesmo nome que a minha spec usou. Um modelo atual sabe o que é idempotência sem spec.
O que ele chutou diferente
Cinco decisões, seis checagens reprovadas. Cada chute se defende sozinho. Nenhum é o que eu queria:
Onde a execução de uma linha chutou
| Decisão | O prompt de uma linha chutou | A spec dizia |
|---|---|---|
| Chega um duplicado enquanto o primeiro ainda roda | 409 + Retry-After (49 de 50 requisições) | 200 com a cobrança do vencedor |
| Vida útil da chave | Para sempre | 24 horas a partir do createdAt da cobrança |
| Status do replay | O 201 original | 200 |
| Chave vazia ou com 256 caracteres | 422 | 400 |
| Mesma chave, outro valor | 422 "Idempotency-Key was already used with different parameters" | 422 "Idempotency-Key reused with different parameters" |
Ele também reportou o próprio buraco, mérito dele: a chave e a cobrança são duas escritas separadas, então um crash entre elas deixa a chave presa “em andamento” e todo retry recebe 409 para sempre. O meu design.md escolheu outro mecanismo: a chave fica na própria linha da cobrança e a unique constraint faz o trabalho, então é uma escrita só e nenhum estado preso. Essa escolha foi minha, não do agente.
O retrabalho da execução de uma linha: adicionar expiração, mudar o que os duplicados concorrentes recebem e corrigir três coisas que o cliente vê. Numa API real, você descobre isso depois que o time de mobile já publicou em cima do status code errado.
Onde a execução com spec escorregou
Em dois pontos. Ela pulou a reformulação do “Confirm before building” e foi direto para o código (headless, não havia ninguém para ler). E onde a spec era omissa, quando as três tentativas de insert perdem uma corrida, ela escolheu um 409 por conta própria e avisou no resumo. Respeitou todas as linhas de Never: nenhuma dependência, testes existentes intactos, GET sem mudança. E fechou citando a saída dos testes (# tests 14, # pass 14, # fail 0) porque a spec pedia evidência, e não “deve passar”.
O que este teste mostra, e o que não mostra
A spec não deixou o agente mais inteligente. Ela fez das decisões as minhas. Cinco das seis checagens que a execução de uma linha reprovou levam a uma pergunta que o próprio agente levantou quando rodei a etapa de entrevista no mesmo repo inicial (as perguntas estão abaixo); a sexta é o texto de uma mensagem de erro. Ele sabia o que perguntar e, sem spec, respondeu sozinho.
Os limites: n=1. Um modelo, um repo de 247 linhas, uma feature. Eu escrevi a spec e a lista de checagens. O agente nunca viu o arquivo de testes, mas a tabela de aceite da spec descreve 12 das 14 checagens em palavras, porque colocar os critérios de aceite na spec é o método; e o design.md entregou o mecanismo. Então a execução com spec foi avaliada contra critérios que ela leu, e a de uma linha contra critérios que ela não tinha como conhecer. Esse é o objetivo de uma spec e também o viés deste teste. A execução com spec custou US$ 0,021 a mais de agente; o meu tempo escrevendo a spec eu não medi. Guardei os logs JSON brutos, os diffs e os testes de aceite das duas execuções.
O único teste de uma boa spec
O teste vem antes de qualquer template.
Você não diria a ela: “Faz aquele negócio com as tarefas.”
Você diria: “Quando alguém cria uma tarefa, salva o título, confere se a pessoa tem permissão naquele workspace e manda uma notificação em tempo real para todo mundo que está vendo aquela lista agora.”
Esse nível de especificidade é a spec. O agente não é pouco inteligente: ele só não tem contexto entre sessões. Toda conversa começa do zero. A spec é a única memória que ele recebe.
O princípio não é sobre simplificar demais. Ele obriga cada regra implícita a aparecer. “Checar permissões” é fácil de dizer numa conversa. Numa spec, você precisa escrever: quais permissões? Em quais operações? O que acontece na falha: rejeição silenciosa ou resposta de erro? A checagem de permissão vem antes ou depois da validação do input? Cada uma dessas é uma pergunta que o agente vai responder de algum jeito. O princípio é como você controla essas respostas.
Seja específico, não genérico
Requisitos vagos são onde os agentes alucinam escopo. A correção é precisão.
Vago vs. executável
| Vago: o agente chuta | Executável: o agente sabe |
|---|---|
| "O sistema deve ser rápido." | GET /api/v1/tasks responde em menos de 500ms no p95 para listas de até 1.000 tarefas. |
| "Valide o título." | Vazio → "Title is required"; 1 caractere → "Min 2 characters"; 501 caracteres → "Max 500". |
| "Trate os erros com elegância." | Em timeout do provedor, tenta de novo 3x com backoff exponencial e depois manda para uma fila de revisão manual. |
| "A UI deve ficar limpa." | A lista de tarefas renderiza em menos de 200ms. Skeleton durante o carregamento. Estado vazio: "No tasks yet. Create one." |
A pergunta certa para cada requisito: “Se eu desse esta linha para alguém sem contexto, a pessoa conseguiria implementar sem mais nenhuma pergunta?” Se a resposta for não, deixe mais específico. Adjetivos (rápido, limpo, seguro, robusto) não são requisitos. São convites para o agente preencher com as próprias premissas.
Declare o escopo negativo
O que você explicitamente não vai construir importa tanto quanto o que vai. Essa é a melhor defesa contra um agente que, “na boa vontade”, adiciona features que você nunca pediu.
Escreva como uma lista simples, no começo do documento. Chame a seção de “Non-Goals” ou “Out of Scope”. Seja direto:
## Non-Goals (v1)

- No recurring tasks
- No calendar integration (planned v2)
- No time tracking
- No task dependencies, subtasks only, max 50 per task
- No bulk operations (multi-select, bulk delete)
- No offline mode
Essa seção evita uma classe de erro que fica invisível até sair caro: o agente estende o modelo de dados para uma feature que você não queria, e agora você está há três horas refatorando algo que nunca pediu para construir.
Passei a colocar uma justificativa de uma linha em qualquer item que possa parecer esquecimento. “Sem controle de horas. O produto não compete em analytics.” Essa linha fecha uma lacuna que o agente poderia preencher com a resposta errada.
Exemplos concretos ganham de adjetivos
Regras de validação abstratas são implementadas errado com frequência. Exemplos concretos, não.
Não escreva “validar o título da tarefa adequadamente”. Escreva uma tabela:
Campo de título: exemplos de validação
| Input | Resultado esperado |
|---|---|
| "" (string vazia) | Erro: "Title is required" |
| "A" (1 caractere) | Erro: "Title must be at least 2 characters" |
| "Review PR #123" (válido) | Sucesso: título salvo |
| "A" × 501 (501 caracteres) | Erro: "Title must be 500 characters or fewer" |
| " " (só espaços) | Erro: "Title is required" (trim antes de validar) |
Essa última linha é a que morde toda vez. Nenhum agente vai adicioná-la se você não adicionar, porque nada em “validar o título da tarefa” implica fazer trim antes de validar. Exemplos concretos transformam interpretação em verificação: o agente produz a saída exata para aquele input, ou não produz.
Esse padrão funciona para qualquer validação, qualquer máquina de estados, qualquer fluxo condicional. Pense em pares de input/output e escreva os pares. É o jeito mais direto de especificar comportamento.
Escreva requisitos EARS, não adjetivos
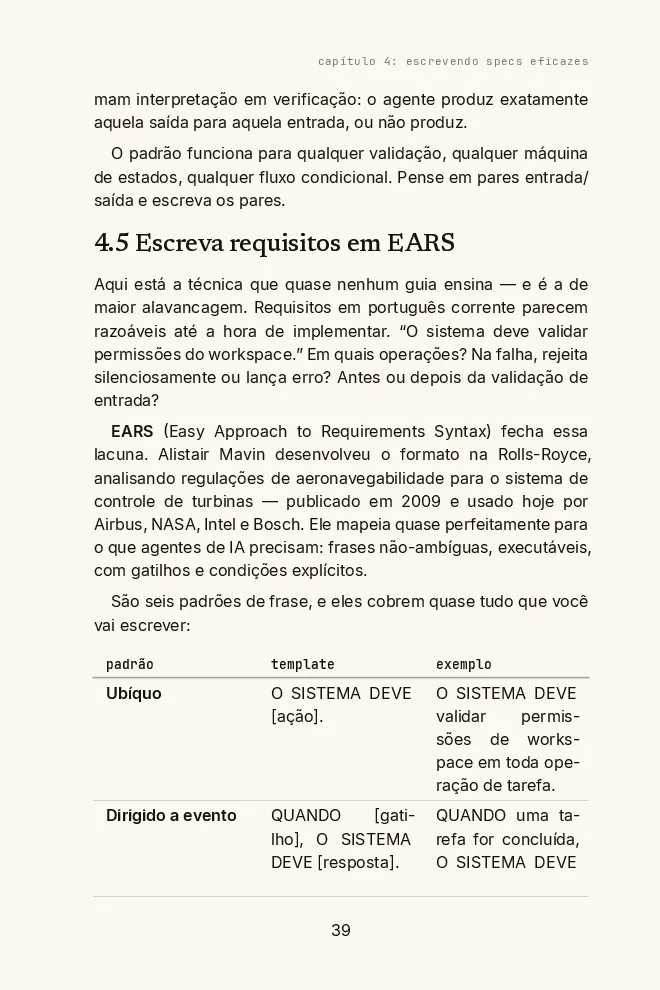
Requisitos em linguagem natural parecem razoáveis até você implementar. “O sistema deve validar as permissões do workspace.” Em quais operações? Na falha, rejeita em silêncio ou lança um erro? Antes ou depois da validação do input?
O EARS (Easy Approach to Requirements Syntax) fecha essa lacuna. Alistair Mavin o desenvolveu na Rolls-Royce PLC enquanto analisava regulamentos de aeronavegabilidade para o sistema de controle de um motor a jato. Foi publicado pela primeira vez em 2009 e hoje é usado por Airbus, NASA, Intel e Bosch (segundo a página do EARS mantida por Mavin). Ele se encaixa quase perfeitamente no que agentes de IA precisam: frases sem ambiguidade, executáveis por máquina, com gatilhos e condições explícitos.
O Kiro, a IDE agêntica da AWS, escreve o requirements.md exatamente nesse formato: WHEN [condition/event] THE SYSTEM SHALL [expected behavior] (docs do Kiro, checado em 13 de outubro de 2026). Aprenda EARS uma vez e você consegue ler e editar o que o Kiro gera.
Os seis padrões do EARS
| Padrão | Template | Exemplo |
|---|---|---|
| Ubíquo | THE SYSTEM SHALL [ação]. | THE SYSTEM SHALL validar as permissões do workspace em toda operação com tarefas. |
| Orientado a evento | WHEN [gatilho], THE SYSTEM SHALL [resposta]. | WHEN uma tarefa é concluída, THE SYSTEM SHALL registrar o timestamp e o usuário que a concluiu. |
| Orientado a estado | WHILE [estado], THE SYSTEM SHALL [restrição]. | WHILE uma tarefa está arquivada, THE SYSTEM SHALL NOT permitir edições. |
| Comportamento indesejado | IF [condição indesejada], THE SYSTEM SHALL [mitigação]. | IF mais de 50 subtarefas forem criadas, THE SYSTEM SHALL mostrar "Subtask limit reached" e rejeitar a operação. |
| Opcional | WHERE [feature flag / config], THE SYSTEM SHALL [comportamento]. | WHERE as notificações estão ativadas, THE SYSTEM SHALL notificar todos os responsáveis quando uma tarefa muda de status. |
| Complexo | WHEN [evento] AND [condição], THE SYSTEM SHALL [A] BEFORE [B]. | WHEN uma tarefa é concluída AND existe uma regra de automação configurada, THE SYSTEM SHALL rodar a automação BEFORE atualizar o status da tarefa. |
Você não usa os seis em todo requisito. Combine o padrão com o tipo de requisito. Uma invariante constante é Ubíquo. Uma ação do usuário é Orientado a evento. Uma condição de guarda é Orientado a estado. Escolha o template, preencha as lacunas e a ambiguidade se desfaz.
Uma nota prática sobre vocabulário: o EARS usa SHALL (comportamento obrigatório) e SHALL NOT (comportamento proibido). Mapeie direto para o MoSCoW: SHALL = Must Have, SHOULD = Should Have, MAY = Could Have. Não amoleça. “The system should validate permissions” não é o mesmo requisito que “THE SYSTEM SHALL validate permissions.” O primeiro dá ao agente uma saída. O segundo, não.
A técnica do Implementation FAQ
Antes de o agente ver a spec, pergunte a si mesmo: o que ele vai ter que adivinhar?
Liste cada ambiguidade e responda na própria spec, numa seção explícita de perguntas e respostas. Chame de “Implementation FAQ” ou “Open Questions”. Cada lacuna que você expõe vira uma decisão tomada de propósito, e não uma premissa errada embutida em silêncio no código.
Veja como isso fica para uma feature de gestão de tarefas:
## Implementation FAQ

**Q: What happens when a user tries to delete a task that has subtasks?**
A: Cascade delete all subtasks. Prompt for confirmation:
"This will also delete 3 subtasks. Continue?" Require explicit
confirmation before proceeding.

**Q: Who can see unassigned tasks?**
A: All members of the workspace, regardless of role. Only workspace
owners can assign tasks to others.

**Q: What happens if an assignee is removed from a workspace while they
have open tasks?**
A: Tasks remain open. The assignee field becomes null. A system
notification is sent to the workspace owner listing affected tasks.

**Q: Can a task belong to more than one project?**
A: No, one task belongs to exactly one project. This is a v1
constraint, not a design choice to revisit.

**Q: What timezone is used for due dates?**
A: Store as UTC. Display in the authenticated user's profile timezone.
If no timezone is set, display UTC with a "(UTC)" label.
As entradas de que você mais precisa são as que estão fora do caminho feliz: exclusão em cascata, estados conflitantes, usuários removidos, fuso horário, edições concorrentes. São exatamente os casos que os agentes tratam pior quando ficam por conta própria, porque os dados de treino estão saturados de implementações do caminho feliz e quase vazios de edge cases.
Eu escrevo o FAQ imaginando o agente no meio da implementação, chegando num ponto de decisão sobre o qual a spec não diz nada. O que ele faria? Essa situação vai para o FAQ, com a resposta certa do lado.
Defina limites em três níveis: sempre, pergunte antes, nunca
Non-Goals cercam o escopo. Limites cercam o comportamento do agente enquanto ele trabalha. As lições do GitHub com mais de 2.500 arquivos agents.md (Matt Nigh, novembro de 2025) escrevem os limites em três níveis: sempre faça, pergunte antes, nunca faça. Os mesmos três níveis cabem numa spec de feature, no escopo da feature.
Limites do meu teste
| Nível | Significado | O que a spec dizia |
|---|---|---|
| Always (sempre) | Faça sempre, sem pedir permissão | Rode npm test antes de terminar e cole a linha de resumo. Mantenha valores como centavos inteiros. |
| Ask first (pergunte antes) | Pare e pergunte antes de fazer | Mudar a API pública de src/db.ts. Adicionar uma tabela ou uma unique constraint pode. |
| Never (nunca) | Parada obrigatória, seja qual for o motivo | Adicionar dependências. Editar ou apagar os testes existentes. Mudar o GET /v1/charges/:id. |
A execução com spec respeitou as três linhas de Never. A execução de uma linha não tinha limites e acrescentou seus cinco testes novos no arquivo de testes existente. Inofensivo num repo de brinquedo. Num repo em que esse arquivo é de outro time, é a edição que você reverte no review.
Um detalhe do “pergunte antes”: numa execução headless ninguém responde. Diga o que o agente deve fazer no lugar (parar e reportar, ou escolher e sinalizar), senão o nível não significa nada.
Deixe o agente te entrevistar, depois comece do zero
Você não precisa escrever o primeiro rascunho sozinho. As Claude Code best practices da Anthropic agora dizem com todas as letras: em features maiores, peça para o Claude te entrevistar e escrever uma spec e, “com a spec completa, comece uma sessão nova para executá-la”. A sessão nova tem contexto limpo e uma spec escrita como referência.
O ciclo de duas sessões
Comece com um prompt mínimo e peça para ser entrevistado.
O agente lê o repo e pergunta sobre as partes difíceis antes de escrever uma linha. Este é o prompt da Anthropic, palavra por palavra.
Digite isto
I want to build [brief description]. Interview me in detail using the AskUserQuestion tool. Ask about technical implementation, UI/UX, edge cases, concerns, and tradeoffs. Don't ask obvious questions, dig into the hard parts I might not have considered. Keep interviewing until we've covered everything, then write a complete spec to SPEC.md.
Revise a spec e construa numa sessão nova.
A entrevista enche o contexto de exploração. A construção ganha uma janela limpa e o arquivo.
Em vez de
Agora pode construir. (mesma sessão, contexto cheio)
Digite isto
Implement the spec in spec/<feature>/. Follow it exactly.
Rodei a etapa de entrevista no mesmo repo inicial, numa sessão headless nova que não tinha visto nenhuma das construções, com uma variação desse prompt: “Before anyone writes code, interview me: read the repo, then ask me the questions you need answered to write a spec for this feature, most important first.” Headless, então ele listou as perguntas em vez de fazer uma de cada vez, e ninguém respondeu: 12 perguntas em 13 segundos, por US$ 0,056. Ele leu o código primeiro e percebeu que o banco em memória cede a vez entre as chamadas, então um check-then-insert teria corrida. Depois perguntou sobre as decisões que a minha spec já tinha tomado:
Perguntas que o agente fez (resumidas)
| O agente perguntou | Minha spec decidiu | A execução de uma linha chutou |
|---|---|---|
| Replay: o mesmo 201 ou um 200? Um header de marcação? | 200 + Idempotent-Replayed: true | 201, com o header |
| Mesma chave, outro body: rejeitar? 422 ou 409? | 422, mensagem exata | 422, outra mensagem |
| Um duplicado com o primeiro ainda rodando: 409 ou esperar? | 200 com a cobrança do vencedor | 409 + Retry-After |
| Uma requisição que falhou (422) consome a chave? | Não, a chave fica livre | Não (igual) |
| O header é opcional ou obrigatório? | Opcional; sem header, comportamento de hoje | Opcional (igual) |
| Tamanho máximo da chave? 400 ou 422 quando inválida? | 1-255 caracteres, 400 | 1-255 caracteres, 422 |
| Chaves para sempre ou expiram em algo como 24 horas? | 24 horas a partir do createdAt | Para sempre |
O agente é bom em achar as decisões e não tem como saber as suas respostas. Responda às perguntas dele e você tem boa parte do Implementation FAQ e da tabela de aceite.
Do SRS para a spec de agente de IA
Quem procura um “template de spec” ou uma “especificação de requisitos de software” geralmente está resolvendo um problema de coordenação entre pessoas. Quer um documento que alinhe o time, receba o aval dos stakeholders e sobreviva a uma passagem de bastão. O formato clássico de SRS do IEEE-830, com introdução, escopo, requisitos funcionais, requisitos não funcionais, especificações de interface e restrições, foi desenhado exatamente para isso. E resolveu razoavelmente bem.
O trabalho muda quando quem lê a spec é um agente de IA.
Um time humano carrega contexto de uma reunião para outra. Faz perguntas antes de começar. Percebe quando algo parece errado e vem checar com você. Um agente de IA não faz nada disso. Ele começa cada sessão sem nenhuma memória das conversas que vocês tiveram, sem lembrar das decisões que você tomou semana passada e sem intuição nenhuma sobre as suas regras de negócio implícitas. Tudo o que o agente precisa saber tem que estar no documento.
A especificação de requisitos de software clássica tinha cinco seções principais: introdução, descrição geral, requisitos funcionais, requisitos não funcionais e interfaces externas. Os times escreviam em prosa, organizada por feature. Essa estrutura continua sendo o esqueleto certo. O que muda com agentes de IA não é a forma, são as premissas por baixo dela.
Um SRS tradicional podia contar com contexto compartilhado. Todo engenheiro do time tinha participado das sessões de planejamento. Conhecia a história do produto. Tirava dúvidas na daily. O conhecimento implícito não precisava ser escrito porque existia na cabeça das pessoas. Um agente de IA não tem nada disso. Se a sua spec diz “validar permissões”, o agente não tem como perguntar o que você quis dizer. Ele chuta e segue em frente.
Três mudanças tornam o SRS executável por um agente, e não só legível por um time.
Primeiro, o EARS fecha a ambiguidade no nível da frase, que o IEEE-830 nunca tratou. A norma dizia que “os requisitos devem ser inequívocos”. O EARS dá a gramática para garantir isso frase a frase: WHEN, WHILE, IF, WHERE, SHALL.
Segundo, o escopo negativo protege você de acréscimos plausíveis. Um time humano sabe o que não está construindo porque estava na sala quando a decisão foi tomada. O agente não estava. Uma seção “Out of Scope” explícita é obrigatória, não opcional.
Terceiro, uma linha final de “Confirm before building” impede um agente afobado de sair correndo para o código antes de verificar o que entendeu. Você termina a spec pedindo que o agente reformule os requisitos principais com as próprias palavras antes de escrever um caractere de código. Se ele entendeu algo errado, você descobre a custo zero, e não depois de três sessões de implementação.
Todo o resto do SRS clássico, os IDs de rastreabilidade, os critérios de aceite, a seção de restrições, a tabela de riscos, se transfere direto. A estrutura estava certa. O público mudou.
Uma spec que nunca pode cobrar em dobro
O melhor jeito de ver essas técnicas juntas é um caso real e difícil. Isto aqui é bem próximo da spec que escrevi para a fintech cripto: um endpoint de cobrança em que um retry nunca pode cobrar o cliente duas vezes.
# Spec: Create a payment charge (POST /v1/charges)
# Status: requirements:approved

## Overview
A merchant creates a charge against a customer. This moves money, so it
must be safe to retry and impossible to double-bill.

## In scope
- Create a charge from an authenticated merchant request.
- Return the charge id and status.
- Guarantee exactly-once billing under client retries.

## Out of scope (v1)
- Refunds (separate spec: 005-refunds).
- Partial captures.
- Multi-currency. All amounts are BRL, stored as integer cents. Never float.

## Functional requirements (EARS)
- FR-1  WHEN a merchant POSTs a charge with a valid Idempotency-Key,
        THE SYSTEM SHALL create at most one charge for that key.
- FR-2  WHEN the same Idempotency-Key is replayed within 24h,
        THE SYSTEM SHALL return the original charge and create no new one.
- FR-3  IF the amount is <= 0,
        THE SYSTEM SHALL reject with 422 "amount must be positive".
- FR-4  IF the merchant is over its rate limit,
        THE SYSTEM SHALL reject with 429 and a Retry-After header.
- FR-5  WHILE a charge is pending,
        THE SYSTEM SHALL NOT allow a second capture.

## Acceptance criteria (examples the agent must satisfy)
- amount=1000, key=abc            -> 201, status=pending
- same key=abc, replayed          -> 200, same charge id, no new row
- amount=0                        -> 422 "amount must be positive"
- amount=-50                      -> 422 "amount must be positive"
- 6th request in 1s, one merchant -> 429, Retry-After: 1

## Non-functional
- p95 latency under 300ms at 200 requests/sec per merchant.
- Every money value is an integer. No floating point anywhere in the path.

## Data
- charges(id, merchant_id, amount_cents, currency, status,
          idempotency_key, created_at)
- UNIQUE(merchant_id, idempotency_key)   # this is what enforces FR-1

## Verification
- Integration test replays one key 50x concurrently; assert exactly one
  row and one ledger entry.
- Load test holds p95 < 300ms at 200 rps.
- Paste the test output. "Should pass" is not evidence.

## Confirm before building
Do not write code until you restate FR-1 through FR-5 and the uniqueness
constraint in your own words. If any acceptance criterion is ambiguous,
ask before implementing.
Vou mostrar por que cada parte merece estar ali.
“Out of scope” nomeia o que esta spec não cobre. Sem isso, o agente poderia estender a tabela de cobranças com uma coluna refund_amount, porque reembolso parece relacionado. São colunas a mais, arquivos de migration e um modelo de dados agora acoplado a uma feature que você ainda nem especificou.
FR-1 e FR-2 juntos especificam a idempotência pelos dois lados: no primeiro recebimento, cria uma cobrança; no replay, devolve a original. Dizer duas vezes fecha a lacuna nas duas direções. Uma frase EARS só não basta aqui, porque as duas situações (primeira chamada vs. chamada repetida) geram respostas HTTP diferentes.
FR-3 e FR-4 são o padrão de “comportamento indesejado”. Eles especificam o que o sistema precisa fazer quando algo dá errado. Sem eles, o agente escolhe as próprias respostas de erro. Às vezes 400, às vezes 500, às vezes nada.
A seção de critérios de aceite não é um arquivo de teste. É uma tabela de pares input/output que mora na spec para o agente verificar o próprio trabalho antes de você revisar qualquer coisa. Cada linha é uma checagem que o agente consegue rodar.
“Every money value is an integer. No floating point anywhere in the path.” Essa frase evita o erro de arredondamento de ponto flutuante que pega um sistema de pagamentos no segundo dia em produção. Ela mora na spec, não num comentário de código, porque comentário não sobrevive à troca de sessão.
A constraint UNIQUE no modelo de dados é o que de fato garante o FR-1. Se você deixar de fora, o agente pode implementar a idempotência na lógica da aplicação. Lógica de aplicação falha com retries concorrentes. A constraint do banco, não.
“Confirm before building” é a última linha. O agente reformula FR-1 a FR-5 com as próprias palavras antes de digitar um caractere de código. Se ele entendeu o FR-2 errado, você descobre agora, a custo zero. Pule essa linha e você descobre depois da implementação.
Esse é o gate de entrada. O gate de saída é evidência. O guia da Anthropic pede isso diretamente: que o Claude “mostre evidência em vez de afirmar sucesso”. A última linha de Verification diz a mesma coisa. No meu teste, a execução com spec fechou com # tests 14, # pass 14, # fail 0 porque a spec pedia a saída. A execução de uma linha escreveu que os 9 testes passavam e não mostrou nenhum.
Três documentos, não um
A spec de uma feature real não é um documento. São três, e eles têm uma ordem rígida.
Pasta de spec da feature
- spec/
- tasks-feature/
- .statusgaterequirements:draft → approved, design:draft → approved, tasks:draft → approved
- requirements.mdO QUÊ: aprovado antes de o design começar
- design.mdCOMO: aprovado antes de as tarefas começarem
- tasks.mdQUANTO: aprovado antes de a implementação começar
O arquivo .status é o gate. O agente lê esse arquivo no início de toda sessão. Se ele diz requirements:draft, nenhum trabalho de design avança. Cada documento faz parte de uma cadeia de dependência: o design mapeia para os requisitos, as tarefas mapeiam para o design. Se você escreve os três de uma vez sem os gates de aprovação, vira waterfall. Com os gates, você tem iteração deliberada, em que cada fase é travada antes de a próxima abrir.
requirements.md: O QUÊ
É o documento que você escreve primeiro e o único que vai para revisão de um stakeholder não técnico. Ele se mantém independente de tecnologia.
Seções: Overview, Goals, Non-Goals, User Stories (US-001…) com critérios de aceite, Functional Requirements (FR-001… em EARS com prioridade MoSCoW), Non-Functional Requirements (NFR-001…), Constraints, Decisions (D-001…), Implementation FAQ (Q-001…), Success Metrics, Risks.
Esses IDs (US-001, FR-001, NFR-001, D-001) são como o design se liga de volta aos requisitos, como as tarefas se ligam de volta ao design e como você responde “por que esse código existe?” seis meses depois sem ler a codebase inteira. Nunca pule.
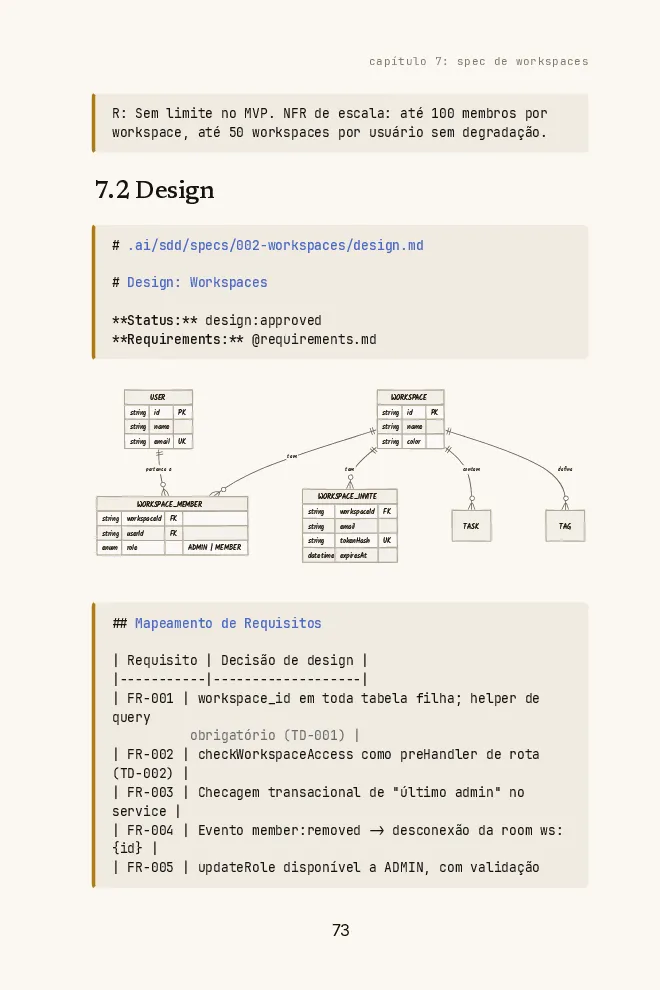
design.md: COMO
É o documento técnico. Todo requisito funcional precisa ter uma decisão de design correspondente. Se um requisito não mapeia para o design, ou o design está incompleto, ou o requisito não precisa ser implementado.
Seções: Executive Summary (a arquitetura em duas frases), Requirements Mapping (tabela explícita: o FR-001 mapeia para qual seção do design), System Architecture, Data Model, API Contract, Edge Cases, Testing and Verification Strategy, Technical Decisions (TD-001… com alternativas consideradas e justificativa), Risks.
A tabela de mapeamento de requisitos é a seção mais importante e a mais pulada. Ela força uma checagem: todo FR precisa ter um lugar no design. Qualquer FR sem mapeamento é uma lacuna, e uma lacuna no design é uma lacuna no código.
tasks.md: QUANTO
É o que o agente implementa, uma tarefa por vez. As tarefas têm entre 2 e 4 horas cada. Qualquer coisa maior é quebrada.
Seções: Requirement Coverage (rastreabilidade de FR para tarefas), Implementation Readiness Check (um gate de passa/não passa: requisitos e design estão aprovados? todos os itens Q-001 foram respondidos?), Tasks, cada uma com título, referência ao requisito (FR-003), arquivos que vai tocar, tamanho estimado, dependências de outras tarefas, critérios de aceite e comandos de verificação.
Os critérios de aceite de cada tarefa são o que o agente roda para verificar o próprio trabalho antes de marcar a tarefa como concluída. Se os critérios não estão lá, o agente declara vitória com base no que ele acha que o código parece, não em se ele funciona de verdade.
O template do requirements.md
Coloque isto na pasta da feature, preencha cada seção e entregue ao agente. É a estrutura exata que uso em toda feature.
# [Feature Name], Requirements

**Status:** draft
**Version:** 1.0
**Author:** [name]
**Date:** [YYYY-MM-DD]

---

## Overview

[One paragraph: what this feature does, why it exists now, and who it's for.]

## Goals

- [Measurable goal 1, e.g., "Users can create and assign tasks in under 30 seconds."]
- [Measurable goal 2]
- [Measurable goal 3]

## Non-Goals (v1)

- [Thing you will NOT build, be explicit]
- [Another thing out of scope, add rationale if the omission might look like a mistake]
- [Third item]

## User Stories

### US-001: [Story title]

**As a** [persona],
**I want to** [action],
**so that** [benefit].

**Acceptance criteria:**

- [ ] [Observable, testable criterion]
- [ ] [Observable, testable criterion]
- [ ] [Edge case criterion]

### US-002: [Story title]

[Repeat structure]

---

## Functional Requirements

### FR-001, [Requirement name] [Must Have]

THE SYSTEM SHALL [specific, unambiguous behavior].

**Priority:** Must Have
**User story:** US-001
**Notes:** [Any clarification or related constraint]

### FR-002, [Requirement name] [Must Have]

WHEN [trigger], THE SYSTEM SHALL [response].

**Priority:** Must Have
**User story:** US-001

### FR-003, [Requirement name] [Should Have]

WHILE [state], THE SYSTEM SHALL NOT [prohibited action].

**Priority:** Should Have
**User story:** US-002

### FR-004, [Requirement name] [Must Have]

IF [unwanted condition], THE SYSTEM SHALL [mitigation].

**Priority:** Must Have
**User story:** US-001

### FR-005, [Requirement name] [Could Have]

WHERE [feature flag / config], THE SYSTEM SHALL [behavior].

**Priority:** Could Have
**User story:** US-002

### FR-006, [Requirement name] [Must Have]

WHEN [event] AND [condition], THE SYSTEM SHALL [A] BEFORE [B].

**Priority:** Must Have
**User story:** US-001

[Continue with FR-007, FR-008...]

---

## Non-Functional Requirements

### NFR-001, Performance

THE SYSTEM SHALL respond to [specific endpoint or operation] in under
[X]ms at p95 for [load condition, e.g., "lists up to 1,000 tasks"].

### NFR-002, Security

THE SYSTEM SHALL [specific security behavior, e.g., "validate a signed
JWT on every mutation before any business logic runs"].

### NFR-003, Accessibility

THE SYSTEM SHALL meet WCAG 2.1 AA for all new UI components in scope.

---

## Constraints

- **Technology:** [e.g., "Must use the existing PostgreSQL instance, no new databases."]
- **Timeline:** [e.g., "Must ship before [date] to support [event]."]
- **Compliance:** [e.g., "All PII fields must be encrypted at rest."]
- **Integration:** [e.g., "Must call the existing notification service via its current API, no schema changes."]

---

## Boundaries

- **Always:** [e.g., "Run the test suite before finishing and paste the summary line."]
- **Ask first:** [e.g., "Changing a public API or a shared module." Say what to do when nobody answers.]
- **Never:** [e.g., "Add dependencies. Edit existing tests. Touch files outside src/tasks/."]

## Commands

- **Test:** `[npm test]`
- **Lint / typecheck:** `[npm run lint]`
- **Files to start from:** `[src/tasks/service.ts]`, `[src/tasks/schema.ts]`

---

## Decisions

### D-001: [Decision title]

**Decision:** [What was decided]
**Rationale:** [Why, include what problem it solves]
**Alternatives considered:** [What else was evaluated and why it was rejected]
**Date:** [YYYY-MM-DD]

---

## Implementation FAQ

**Q: [Anticipated ambiguity 1, focus on edge cases and deletion behavior]**
A: [Explicit answer, no hedging, no "it depends"]

**Q: [Anticipated ambiguity 2, conflicting states, concurrent operations]**
A: [Explicit answer]

**Q: [Access / visibility edge case]**
A: [Explicit answer, who sees what under which conditions]

**Q: [Timezone / locale / formatting question if relevant]**
A: [Explicit answer, specify storage format and display format separately]

---

## Success Metrics

- [ ] [Metric 1, e.g., "P95 latency for task list under 500ms in staging under 1,000-task load."]
- [ ] [Metric 2, user-observable outcome if no instrumentation exists]
- [ ] [Metric 3]

---

## Verification evidence

- [The end-to-end check that proves the feature works, e.g., "50 concurrent
  requests with one key create exactly one row."]
- Paste the command you ran and its output. "Should pass" is not evidence.

---

## Risks

| Risk     | Likelihood       | Impact           | Mitigation   |
| -------- | ---------------- | ---------------- | ------------ |
| [Risk 1] | Low / Med / High | Low / Med / High | [Mitigation] |
| [Risk 2] |                  |                  |              |
Livro gratuito · 177 páginas · PDF + EPUB
Com o requirements.md pronto, faltam o design.md e o tasks.md. O livro traz os dois templates e skills de Claude Code que conduzem cada fase da spec com você.
Onde esta spec mora no Kiro, no Spec Kit e no OpenSpec
O template não depende de ferramenta. Toda ferramenta de spec divide o trabalho do mesmo jeito em três partes, O QUÊ, COMO e a lista de tarefas, com nomes de arquivo diferentes. Se você troca de ferramenta, este é o mapa:
A mesma spec, quatro casas
| Ferramenta | Requisitos (O QUÊ) | Design (COMO) | Tarefas | Gate |
|---|---|---|---|---|
| Kiro | requirements.md em EARS (bugfix.md para bugs) | design.md | tasks.md | Aprovação entre as fases; o Quick Spec pula os gates |
| Spec Kit 1.0.13 | specs/001-feature/spec.md, mais um constitution.md do repo inteiro | plan.md | tasks.md | Uma skill por fase; você roda cada uma |
| OpenSpec 1.14.1 | openspec/changes/<name>/proposal.md + um delta da spec | design.md | tasks.md | O archive aplica o delta em openspec/specs/ |
| Claude Code, sem kit | spec/<feature>/requirements.md | design.md | tasks.md | O arquivo .status; o agente lê em toda sessão |
Meu teste usou a última linha: três arquivos e um .status, sem ferramenta instalada. Se você quer essa pasta com os gates garantidos por skills em vez de disciplina, o claude-sdd-kit é o que eu uso no Claude Code. Os guias mais fundos: o que é o Kiro, GitHub Spec Kit 1.0, OpenSpec da instalação ao archive e os três comparados.
AGENTS.md não é a spec
O AGENTS.md (ou o CLAUDE.md) guarda o que vale para toda tarefa no repo: os comandos, as convenções, os limites que nunca mudam. A spec guarda o que vale para uma feature: os requisitos, os Non-Goals, as checagens de aceite. Ponha regra de feature no AGENTS.md e toda sessão paga por ela em contexto, muito depois de a feature ir para produção. Ponha regra do repo em toda spec e elas se desencontram. Quando um limite aparece em três specs seguidas, promova para o AGENTS.md.
Antes de entregar a spec ao agente
Gate de prontidão da spec
- O princípio da criança esperta passa: alguém sem contexto consegue construir a coisa certa a partir disto.Se você teria que explicar em voz alta algo que não está no documento, o documento não está pronto.
- Todo requisito funcional está em formato EARS.Se você escreveu 'deve ser rápido' ou 'tratar erros com elegância', encontre e substitua.
- Os Non-Goals são explícitos: pelo menos 3 coisas que você não vai construir.A ausência de uma seção de Non-Goals é um risco de escopo, não uma spec enxuta.
- As regras de validação têm tabelas de exemplos de input/output.Regras de validação em prosa quase sempre ficam subespecificadas. Tabelas fecham a lacuna.
- Todas as User Stories têm critérios de aceite testáveis.Se um critério não é testável de forma independente, é um objetivo vago, não um requisito.
- Existem IDs estáveis e únicos: US-001, FR-001, NFR-001, D-001.Você vai referenciá-los no design.md e no tasks.md. Sem IDs, a rastreabilidade quebra.
- O Implementation FAQ cobre os 3 principais edge cases.No mínimo: a exclusão em cascata, o cenário de estado conflitante e qualquer edge case de controle de acesso.
- Requisitos de performance têm números, não adjetivos.'Rápido' não é requisito. '500ms no p95 para listas de até 1.000 tarefas' é.
- A spec termina com uma linha de 'Confirm before building'.O agente reformula os requisitos principais com as próprias palavras antes de digitar código. Se ele entendeu algo errado, você descobre agora, não depois.
- O arquivo .status diz 'requirements:draft' até você revisar e aprovar.Draft não é aprovado. O agente não pode seguir para o design com uma spec em draft.
- Os requisitos não funcionais cobrem performance, segurança e acessibilidade.São as três seções que mais faltam nos primeiros rascunhos.
- Os limites estão em três níveis: sempre, pergunte antes, nunca.O nunca lista as edições que você reverteria no review. O pergunte antes diz o que fazer quando ninguém responde.
- A verificação pede evidência: o comando e a saída dele.Um agente que só diz 'todos os testes passam' não te mostrou nada. Colar a saída faz parte do pronto.
FAQ
Qual deve ser o tamanho de um requirements.md?
Longo o bastante para evitar premissas erradas, curto o bastante para continuar sendo mantido. Uma feature típica de produção fica entre 400 e 800 linhas, contando o boilerplate do template.
Se passou de 1.000 linhas, pergunte se isso é uma feature ou duas. Se está abaixo de 200, pergunte se você de fato respondeu as perguntas difíceis ou só escreveu as perguntas.
Preciso dos três documentos para toda feature?
Para um script descartável ou uma correção de duas horas, não. É só mandar o prompt. O overhead não compensa.
Para qualquer coisa que atravesse várias sessões, envolva escolhas reais de arquitetura ou mexa com dados que você não consegue reescrever fácil, os três se pagam. O design.md evita os erros mais caros; o tasks.md evita o maior desperdício de esforço de implementação.
Qual a diferença entre Non-Goals e Constraints?
Non-Goals são features que você escolheu não construir nesta versão: 'sem tarefas recorrentes'. Constraints são limites dentro dos quais você precisa trabalhar: 'tem que usar o banco existente, sem novos serviços'.
Non-Goals protegem o escopo. Constraints moldam o espaço de solução. Os dois ficam nos requisitos, em seções separadas.
Posso usar este template com outros agentes além do Claude Code?
Sim. O formato é markdown puro. Qualquer agente que lê arquivos se beneficia dessa estrutura: Cursor, Copilot, GPT-4o num custom GPT, Gemini. A sintaxe EARS e os IDs estáveis não dependem de modelo.
O arquivo de gate .status é específico do workflow de SDD que eu uso, mas os documentos em si funcionam com qualquer agente capaz.
Meu time escreve specs no Confluence ou no Notion. Preciso migrar para arquivos markdown?
Não necessariamente. O valor está na estrutura e no conteúdo, não no formato. Dá para escrever a spec no Notion e colar no contexto do agente no início de cada sessão.
O motivo de eu usar arquivos markdown no repositório é rastreabilidade: a spec mora ao lado do código que ela governa, é versionada no git junto com ele e o agente lê direto, sem nenhum copia e cola. Esse último ponto importa mais do que parece. É no atrito que as specs acabam puladas.
Como lido com um requisito que muda no meio da implementação?
Atualize o requirements.md, adicione uma nota de mudança com a data, volte o .status para 'requirements:draft' e aprove de novo antes de o agente continuar.
A disciplina é: nunca deixe o agente implementar a partir de uma spec que você não releu desde a mudança. Um requisito alterado que não se propaga para o design cria uma contradição entre o que o código faz e o que a spec diz. O você do futuro vai ter que desembaraçar isso a frio.
E se eu não souber todas as respostas quando estiver escrevendo a spec?
Escreva o que você sabe e coloque as perguntas em aberto explicitamente na seção de Implementation FAQ, marcadas como abertas, não respondidas. Ainda é melhor que silêncio, porque o agente vê a pergunta e sabe que deve perguntar em vez de chutar.
Depois resolva todas antes de aprovar a spec. Pergunta em aberto numa spec aprovada é bug adiado.
O que são requisitos EARS?
EARS (Easy Approach to Requirements Syntax) é um jeito de escrever cada requisito como uma frase de forma fixa: um gatilho ou condição opcional (WHEN, WHILE, IF, WHERE) seguido de THE SYSTEM SHALL e a resposta. Alistair Mavin e colegas o desenvolveram na Rolls-Royce; foi publicado pela primeira vez em 2009.
Para um agente de IA, a forma fixa tira o espaço para chute: todo requisito diz quando vale e o que precisa acontecer. O Kiro escreve o requirements.md dele em EARS por padrão.
Quanto tempo devo gastar escrevendo uma spec?
Não cronometrei a minha. A spec do meu teste teve 151 linhas de markdown em três arquivos para um endpoint. A etapa de entrevista é o atalho: numa execução separada ela gerou 12 perguntas em 13 segundos, e elas cobriram todas as decisões que a minha spec tinha tomado. Responder a elas é boa parte da escrita.
O que a spec comprou: 14 de 14 checagens de aceite contra 8 de 14 de um prompt de uma linha, por US$ 0,021 a mais de custo de agente.
Como escrevo uma spec para código existente?
Mesmo template, com dois acréscimos. Nomeie os arquivos de onde a mudança parte (a seção Commands) e adicione um Non-Goal para todo comportamento que não pode mudar. As specs de bugfix do Kiro deixam isso explícito com uma linha WHEN [condition] THEN the system SHALL CONTINUE TO [existing behavior].
Rode a etapa de entrevista primeiro: o agente lê o repo antes de perguntar, foi assim que ele achou a corrida no meu repo de teste. Para sistemas legados grandes, o guia de AI-DLC em brownfield aqui do site cobre como fazer a engenharia reversa da spec antes.
AGENTS.md é a mesma coisa que uma spec?
Não. O AGENTS.md (ou o CLAUDE.md) é carregado em toda sessão e guarda o que vale para o repo inteiro: comandos, convenções, limites permanentes. Uma spec guarda uma feature: requisitos, Non-Goals, checagens de aceite. Mantenha regra de feature fora do AGENTS.md; ela custa contexto em toda sessão depois que a feature vai para produção.
Como confiro se o agente seguiu a spec?
Escreva as checagens de aceite antes da construção e rode você mesmo. No meu teste, 14 testes escritos antes das duas construções foram o juiz, e o agente nunca viu o arquivo de testes. Uma suíte escrita por você é mais difícil de burlar do que uma que o agente escreveu junto com o código.
Depois peça evidência, não afirmação: o comando de teste e a saída dele. O guia da Anthropic acrescenta uma etapa de review num subagent novo, que confere o diff contra o plano e reporta as lacunas.
Uma spec ainda ajuda com um modelo forte?
Ajuda, mas não do jeito que as pessoas esperam. No meu teste, o prompt de uma linha acertou a parte difícil: nenhuma cobrança em dobro com 50 retries concorrentes. O que ele não tinha como acertar eram as decisões que só eu podia tomar: status codes, a janela de expiração, o que um duplicado em andamento recebe.
Um modelo forte corta os bugs que vêm de mal-entendido. As decisões continuam suas, e a spec é onde você as escreve.
Para onde ir agora
Uma boa spec leva de 30 a 90 minutos para escrever numa feature típica. Esse tempo volta já na primeira sessão de implementação: você gasta o tempo em problemas que são difíceis de verdade, e não depurando requisitos mal entendidos.
Escrevendo specs para um time em vez de para você? Spec-Driven Development para times cobre o fluxo de spec compartilhada, e AI-DLC vs Spec-Driven Development é o próximo degrau. Vai especificar uma mudança em código legado? AI-DLC em brownfield começa pela engenharia reversa do que o sistema faz hoje.
Livro gratuito · 177 páginas · PDF + EPUB
Você termina o livro escrevendo spec sozinho: aprendeu em português, num projeto real, e fica com templates de requisitos em EARS, design e tasks.
Receber o livro gratuito